지난 LFQ 글은 계산서 한 장을 남기며 끝났습니다. 부호 하나로 토큰을 만드는 LFQ는 비트를 더할 때마다 어휘를 두 배로 불리는 확장성을 얻었지만, 그 어휘가 실제로 고르게 쓰이도록 만드는 엔트로피 페널티는 위치 하나마다 $2^d$개 꼭짓점 전체와의 거리 계산을 요구했습니다. 512 어휘에서는 사실상 공짜였던 이 계산이 $2^{18}$ 어휘에서는 실질적인 부담이 된다는 점, 그리고 바로 이 지점을 비트 사이의 독립을 가정하는 것으로 회피하려 한 BSQ라는 후속 연구가 있다는 것까지 말씀드리고 글을 맺었습니다.
오늘은 그 BSQ(Binary Spherical Quantization)를 다룹니다. BSQ는 UT Austin의 Zhao 등이 2024년 논문 "Image and Video Tokenization with Binary Spherical Quantization"에서 제안한 양자화 방식입니다. 이름을 뜯어 보면 LFQ와 같은 이진(Binary) 양자화인데, 앞에 구면(Spherical)이라는 수식어가 하나 붙었습니다. 실제 연산의 차이도 정확히 그만큼입니다. 부호를 읽기 전에, 잠재 벡터를 단위 초구(Unit Hypersphere) 위에 올려놓는(정규화하는) 한 단계가 추가될 뿐입니다.
놀라운 것은 이 한 단계가 사 오는 것들입니다. 첫째, 양자화 오차에 상한이 생깁니다. LFQ에서는 잠재 벡터와 꼭짓점 사이의 거리가 얼마든지 커질 수 있었지만, BSQ에서는 어떤 입력이 와도 오차가 정해진 값을 넘지 못합니다. 둘째, 양자화의 소프트 할당 확률이 비트별로 인수분해되어, 엔트로피 페널티를 어휘 크기 $2^d$가 아니라 비트 수 $d$에 비례하는 비용으로 계산할 수 있게 됩니다. LFQ가 남긴 두 장의 청구서가 정규화 한 번으로 함께 처리되는 셈입니다.
이번 글에서는 먼저 이 두 이득이 왜 생기는지 수식으로 확인하고, 엔트로피 계산 비용이 실제로 얼마나 갈리는지 직접 시간을 재 봅니다. 이어서 지난 글과 같은 조건(코드북 512, 동일한 인코더·디코더, MNIST)에서 BSQ와 LFQ, 그리고 페널티를 뗀 BSQ까지 세 가지를 나란히 학습시켜, 구면 사영 한 단계가 학습 동역학을 어떻게 바꾸는지 눈으로 확인해 보겠습니다.
1. LFQ가 남긴 두 장의 청구서
첫 번째 청구서는 엔트로피 페널티의 계산 비용입니다. 지난 LFQ 글에서 살펴보았듯, 부호 양자화가 붕괴하지 않으려면 엔트로피 페널티가 필수였고, 그 계산은 위치 하나마다 $2^d$개 꼭짓점 전체와의 거리와 softmax를 요구했습니다. 규모를 넣어 보면 부담이 실감됩니다. $7 \times 7$ 잠재 격자에 배치 256이면 한 스텝에 12,544개의 위치가 있고, 어휘가 MAGVIT-v2 규모인 $2^{18} = 262,144$라면 거리 행렬 하나에 약 33억 개의 항이 들어갑니다. fp32 기준으로 이 행렬 하나가 13GB를 넘으므로, 큰 청크로 쪼개지 않고는 계산 자체가 불가능한 수준입니다. 코드북이 512일 때는 사실상 부담이 없던 이 계산이 $2^{18}$ 규모에서는 실질적인 메모리 벽이 되는 셈입니다.
두 번째 청구서는 상한 없는 양자화 오차입니다. 부호 함수는 입력의 크기를 완전히 무시합니다. $z_i$가 0.1이든 100이든 결과는 똑같이 $+1$이므로, 잠재 벡터가 꼭짓점에서 멀어질수록 양자화 오차 $\Vert{}z - \text{sign}(z)\Vert{}$는 제한 없이 커질 수 있습니다. 오차가 커지면 양자화 전후의 그래디언트 방향이 거의 같다는 STE의 가정이 흔들립니다. 지난 LFQ 글에서도 부호 양자화가 $z$와 꼭짓점 사이의 거리를 키워 STE 근사의 부담을 늘린다는 점을 짚었고, 이것이 LFQ가 커밋먼트 손실($\beta = 0.25$)을 계속 붙들고 있어야 했던 이유이기도 합니다.
두 청구서의 뿌리를 캐 보면 하나로 모입니다. 잠재 벡터의 크기(스케일)가 방치되어 있다는 것입니다. 부호는 방향만 읽는데 크기는 제멋대로이니, 오차도 제멋대로가 되고 소프트 할당의 온도 감각도 위치마다 제각각이 됩니다. BSQ의 답은 단순합니다. 크기를 아예 없애 버리는 것, 즉 모든 잠재 벡터를 단위 초구 위로 올려 버리는 것입니다.
2. BSQ의 핵심 발상: 부호를 읽기 전에 초구에 올린다
연산을 정확히 정의하겠습니다. 인코더 출력의 각 위치에서 $d$차원 벡터 $z \in \mathbb{R}^d$가 주어졌을 때, 먼저 이를 단위 초구 위로 사영(정규화)하고, 그다음 각 차원을 부호로 양자화하되 결과 역시 단위 노름이 되도록 $\sqrt{d}$로 나눕니다.
코드 전체의 집합은 다음과 같습니다.
지난 글에서 LFQ의 코드북이 $d$차원 초입방체의 꼭짓점들이었다면, BSQ의 코드북은 그 초입방체를 단위 구에 내접시킨 모양입니다. 모든 코드가 구면 위에 있고, 입력 $u$도 구면 위에 있습니다. 이때 부호 판정이 곧 최근접 탐색이라는 지난 글의 논리는 그대로 성립합니다. 노름(Norm)이 같은 후보들 사이의 최근접은 내적을 최대화하는 것이고, 내적 $\sum_i u_i c_i$는 각 차원에서 $c_i$가 $u_i$와 부호가 같을 때 최대가 되기 때문입니다. 토큰 인덱스도 지난 글의 식을 그대로 씁니다.
인덱스의 이진 표기가 곧 잠재 벡터의 부호열이라는 "주소와 실체의 일치"도, 조회 없는(lookup-free) 성질도 LFQ에서 그대로 물려받습니다. 부호 함수의 미분 불가능성 역시 같은 해법, 즉 통과 추정기(Straight-Through Estimator, STE)로 처리합니다.
여기서 $\text{sg}[\cdot]$는 늘 그래 왔듯 정지 그래디언트(Stop Gradient) 연산입니다. 최소 골격을 코드로 옮기면 다음과 같습니다. 보조 손실 부분은 4절에서 완성하겠습니다.
class BSQ(nn.Module):
    """Zhao 외(2024)의 Binary Spherical Quantization (최소 골격).
    채널-마지막 (..., d) 입력을 가정합니다."""
    def __init__(self, dim):
        super().__init__()
        self.dim = dim
        self.inv_sqrt_d = dim ** -0.5
        self.register_buffer("basis", 2 ** torch.arange(dim))

    def forward(self, z):
        u  = F.normalize(z, dim=-1)                   # 단위 초구 사영
        q  = torch.where(u > 0, torch.ones_like(u),
                         -torch.ones_like(u)) * self.inv_sqrt_d
        uq = u + (q - u).detach()                     # sign_ste (구 위에서)
        return uq

    def to_indices(self, uq):
        """±1/√d 비트열 -> 정수 토큰 인덱스"""
        return ((uq > 0).long() * self.basis).sum(-1)
LFQ 글의 최소 골격과 나란히 놓고 보면, 달라진 것은 F.normalize 한 줄과 $1/\sqrt{d}$ 배율뿐입니다. 참고로 원 논문의 BSQ-ViT에서는 트랜스포머의 고차원 잠재를 선형 사영으로 저차원 구면에 내렸다가, 양자화 후 다시 선형 사영으로 디코더의 잠재 공간에 올립니다. 이번 글의 실험에서는 인코더의 마지막 $1 \times 1$ 합성곱이 그 하강 사영을, 디코더의 첫 층이 상승 사영을 겸하는 구성입니다.
정리하면 계보가 한 줄로 그려집니다. FSQ는 $\tanh$ 경계 함수로 값을 유한한 범위에 눌러 놓고 반올림했고, LFQ는 경계 없이 부호만 읽었으며, BSQ는 정규화로 유한성을 구면 위에서 되찾았습니다. 이 유한성이 무엇을 사 오는지가 다음 두 절의 주제입니다.
글로만 따라온 이 과정을 $d = 3$에서 직접 만져 볼 수 있게 아래에 준비했습니다. 지난 LFQ 글의 정육면체 위젯과 짝을 이루는 것으로, 단위 구 안에 내접한 정육면체의 여덟 꼭짓점이 코드북 $\{\pm 1/\sqrt{3}\}^3$입니다. 주황색 벡터가 정규화된 잠재 벡터 $u$이고, 슬라이더로 $z$의 세 성분을 바꾸면 그 벡터가 구면 위에서 움직이며 부호가 일치하는 가장 가까운 꼭짓점(밝게 빛나는 점)으로 양자화되는 모습을, 점선으로 표시된 잔차 $u - \hat{u}$와 함께 볼 수 있습니다. 어느 한 축으로 방향을 몰면 잔차가 길어지고 세 축에 고르게 두면 짧아지는데, 이 잔차의 길이가 곧 다음 절에서 다룰 양자화 오차입니다. 구를 드래그하면 회전합니다.
3. 첫 번째 이득: 양자화 오차에 상한이 생긴다
구면 위에서는 오차가 어디까지 커질 수 있는지 직접 계산해 볼 수 있습니다. $u$와 $\hat{u}$가 모두 단위 벡터이므로 둘 사이의 거리는 내적만으로 결정됩니다.
그런데 단위 벡터의 $\ell_1$ 노름은 $1 \le \Vert{}u\Vert{}_1 \le \sqrt{d}$ 범위에 있으므로(하한은 한 축에 몰린 경우, 상한은 모든 축에 고르게 퍼진 경우), 내적은 $u \cdot \hat{u} \in [1/\sqrt{d}, 1]$이고 오차는 다음과 같이 유계입니다.
즉 어떤 입력이 와도 오차는 $\sqrt{2}$를 넘지 못하며, $d = 9$라면 상계는 $\sqrt{2 - 2/3} = \sqrt{4/3} \approx 1.155$입니다. 최악의 경우는 $u$가 한 축에 몰렸을 때, 즉 방향 정보가 한 차원에 집중되어 부호열로 표현하기 가장 불리할 때입니다.
LFQ와의 대비가 선명합니다. LFQ의 오차 $\Vert{}z - \text{sign}(z)\Vert{}$에는 상한이 없고, 입력의 스케일에 그대로 끌려갑니다. 예를 들어 아무 관리 없이 표준정규 분포의 $z$를 넣으면, 성분당 평균 제곱 오차가 일정한 상수(약 0.40)이므로 전체 오차는 대략 $\sqrt{d}$에 비례해 커집니다. 반면 BSQ는 크기를 정규화로 지웠으므로 오차가 오직 방향에만 의존하고, 방향이 고르게 분포하면 평균 오차는 차원과 거의 무관하게 0.6 안팎에 머무릅니다. 말로만 하기보다 직접 확인해 보겠습니다. 아래 스크립트는 여러 차원에서 표준정규 벡터를 뽑아 두 방식의 오차를 잰 것입니다.
# -*- coding: utf-8 -*-
"""양자화 오차의 차원 의존성 데모: LFQ vs BSQ"""
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.ticker as mticker
import unicodedata

# matplotlib 한글 폰트 설정
plt.rcParams['font.family'] = 'Malgun Gothic'
plt.rcParams['axes.unicode_minus'] = False


def rjust_kr(s, width):
    """한글 등 전각 문자를 2칸으로 계산해 표시 폭 기준 오른쪽 정렬합니다."""
    w = sum(2 if unicodedata.east_asian_width(c) in ('W', 'F') else 1 for c in s)
    return ' ' * max(0, width - w) + s


rng = np.random.default_rng(0)
dims = [4, 9, 16, 36, 64, 144, 256]
n = 100_000

lfq_mean, bsq_mean, bsq_max, bound = [], [], [], []
print(f"{'d':>4} | {rjust_kr('LFQ 평균', 10)} | {rjust_kr('BSQ 평균', 10)} "
      f"| {rjust_kr('BSQ 최대', 10)} | {rjust_kr('이론 상계', 10)}")
for d in dims:
    z = rng.standard_normal((n, d))
    q_lfq = np.sign(z)                                   # LFQ: 부호 (±1)
    u = z / np.linalg.norm(z, axis=1, keepdims=True)     # BSQ: 단위 초구 사영
    q_bsq = np.sign(u) / np.sqrt(d)                      # 구 위의 꼭짓점 (±1/√d)
    e_lfq = np.linalg.norm(z - q_lfq, axis=1)
    e_bsq = np.linalg.norm(u - q_bsq, axis=1)
    b = np.sqrt(2 - 2 / np.sqrt(d))
    lfq_mean.append(e_lfq.mean()); bsq_mean.append(e_bsq.mean())
    bsq_max.append(e_bsq.max()); bound.append(b)
    print(f"{d:>4} | {e_lfq.mean():>10.3f} | {e_bsq.mean():>10.3f} "
          f"| {e_bsq.max():>10.3f} | {b:>10.3f}")

plt.figure(figsize=(7.5, 4.8))
plt.plot(dims, lfq_mean, 'o-', label='LFQ: ||z - sign(z)|| 평균')
plt.plot(dims, bsq_mean, 's-', label='BSQ: ||u - û|| 평균')
plt.plot(dims, bound, 'k--', linewidth=1, label='BSQ 이론 상계 √(2 - 2/√d)')
plt.axhline(np.sqrt(2), color='gray', linewidth=0.8, linestyle=':', label='√2')
plt.xscale('log', base=2)
plt.gca().xaxis.set_major_formatter(mticker.FuncFormatter(lambda x, _: f'{x:g}'))
plt.xlabel('차원 d'); plt.ylabel('평균 양자화 오차')
plt.title('표준정규 입력에서의 양자화 오차: LFQ와 BSQ')
plt.legend(); plt.grid(alpha=0.3); plt.tight_layout()
plt.savefig('bsq_bound.png', dpi=150, bbox_inches='tight')
print("\n그림 저장: bsq_bound.png")
d | LFQ 평균 | BSQ 평균 | BSQ 최대 | 이론 상계
4 | 1.216 | 0.525 | 0.988 | 1.000
9 | 1.869 | 0.590 | 1.040 | 1.155
16 | 2.514 | 0.610 | 0.974 | 1.225
36 | 3.795 | 0.625 | 0.905 | 1.291
64 | 5.071 | 0.630 | 0.820 | 1.323
144 | 7.621 | 0.633 | 0.783 | 1.354
256 | 10.165 | 0.634 | 0.733 | 1.369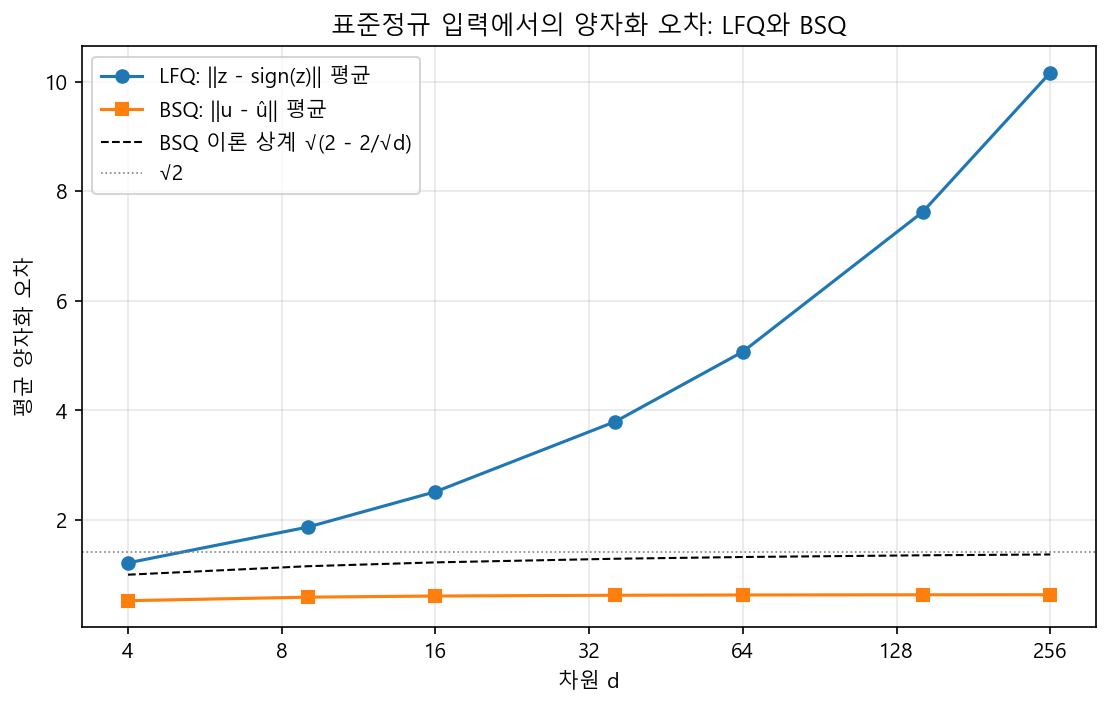
표는 세 가지를 모두 확인해 줍니다. 첫째, LFQ의 평균 오차는 차원이 커질수록 거침없이 증가합니다. $d = 9$에서 1.869였던 값이 $d = 64$에서 5.071, $d = 256$에서 10.165로 늘어 정확히 $\sqrt{d}$에 비례합니다. 실제로 각 값을 $\sqrt{d}$로 나누면 0.62~0.64로 일정한데, 이는 성분당 평균 제곱 오차 약 0.40에서 예상되는 성분당 실효 오차 $\sqrt{0.40} \approx 0.63$과 맞아떨어집니다. 상한이 없다는 사실이 숫자 그대로 드러납니다. 둘째, BSQ의 평균 오차는 $d = 4$의 0.525에서 $d = 256$의 0.634까지, 차원이 64배로 늘어나는 동안 0.1 남짓밖에 움직이지 않고 0.63 부근에 수렴합니다. 크기를 정규화로 지운 덕분에 오차가 차원에 거의 끌려가지 않는 것입니다. 셋째, BSQ의 최대 오차는 모든 차원에서 이론 상계 아래에 머뭅니다. $d = 9$에서 최대 1.040은 상계 1.155보다 작고, 차원이 커질수록 오히려 여유가 벌어져 $d = 256$에서는 최대 0.733이 상계 1.369의 절반을 갓 넘는 수준까지 내려갑니다. 고차원에서는 방향이 한 축에 몰리는 최악의 경우가 확률적으로 극히 드물어지기 때문이며, 상계가 헐거워지는 것이 아니라 실제 분포가 최악에서 멀어지는 것입니다.
한 가지는 정직하게 짚어 두겠습니다. 실제 학습에서 인코더의 출력은 표준정규가 아니며, LFQ의 커밋먼트 손실은 정확히 이 오차가 커지지 않도록 $z$를 꼭짓점 근처에 붙들어 두는 장치입니다. 그러니 이 데모의 요지는 "LFQ의 오차가 실전에서 저렇게 크다"가 아니라, 오차 관리가 손실 항으로 유지해야 하는 성질인가, 구조가 보장하는 성질인가의 차이입니다. LFQ는 커밋먼트라는 손실 항으로 오차를 관리해야 했지만, BSQ에서는 어떤 입력이 와도 오차가 상계를 넘을 수 없으므로 그 관리 자체가 불필요해집니다. 실제로 원 논문도 LFQ 대비 유계 양자화 오차 덕분에 학습이 더 쉽고 수렴이 빠르다고 보고하며, 이번 실험의 BSQ 역시 커밋먼트 손실 없이 구성했습니다. VQ-VAE에서 출발한 보조 장치 목록에서 또 하나가 지워지는 셈입니다. 7절에서 실제 학습된 모델의 오차가 정말 상계 아래에 머무는지도 함께 확인하겠습니다.
4. 두 번째 이득: 엔트로피가 비트별로 쪼개진다
이제 첫 번째 청구서, 엔트로피 페널티의 비용 차례입니다. 지난 글에서 본 페널티의 골격을 다시 적으면 다음과 같습니다.
$$\mathcal{L}_{\text{entropy}} = \mathbb{E}[H(q(z))] - H(\mathbb{E}[q(z)])$$
앞 항은 "각 입력은 하나의 코드에 확신을 가져라", 뒤 항은 "전체로는 코드가 고르게 쓰여라"였습니다. 문제는 이를 계산하려면 소프트 할당 분포 $q$가 필요했고, 지난 글의 구현은 $2^d$개 꼭짓점 전체와의 거리에 softmax를 취해 이 분포를 만들었다는 점입니다.
BSQ에서는 이 소프트 할당이 깔끔하게 쪼개집니다. 구면 위에서는 모든 코드의 노름이 1로 같으므로, 거리가 내적만으로 결정됩니다: $\Vert{}u - c\Vert{}^2 = 2 - 2u \cdot c$. 따라서 거리 기반 softmax는 다음과 같이 비트별 곱으로 정확히 인수분해됩니다.
$$q(c \mid u) \propto \exp(2\tau u \cdot c) = \prod_{i=1}^{d} \exp(2\tau u_i c_i), \qquad q\left(c_i = +\frac{1}{\sqrt{d}} \mid u_i\right) = \sigma\left(\frac{4\tau u_i}{\sqrt{d}}\right)$$
여기서 $\tau$는 지난 글과 같은 역온도(Inverse Temperature)이고 $\sigma$는 시그모이드입니다. 즉 위치 하나의 소프트 할당이 $2^d$차원 분포가 아니라, 서로 독립인 $d$개의 베르누이 분포의 곱이 됩니다. 곱분포의 엔트로피는 각 성분 엔트로피의 합이므로, 표본별 항 $\mathbb{E}[H(q)]$는 정확히 $O(d)$로 계산됩니다.
$$H(q(u)) = \sum_{i=1}^{d} H_b(p_i), \qquad p_i = \sigma\left(\frac{4\tau u_i}{\sqrt{d}}\right)$$
사실 이 인수분해 자체는 코드 노름이 일정한 LFQ에서도 성립합니다($\pm 1$ 꼭짓점은 모두 노름이 $\sqrt{d}$이니까요). 지난 글의 참조 구현이 두 항 모두 전체 열거로 계산했을 뿐입니다. 진짜 벽은 배치 항입니다. $\mathbb{E}[q]$는 곱분포들의 평균인데, 곱분포의 평균은 더 이상 곱분포가 아니므로 $H(\mathbb{E}[q])$를 정확히 구하려면 원리상 $2^d$개 확률을 모두 열거해야 합니다. BSQ의 처방은 여기서 비트 사이의 독립을 가정하는 것입니다. 결합 엔트로피가 주변부 엔트로피의 합을 넘지 못한다는 준가법성에 따라, 다음의 상계로 배치 항을 근사합니다.
이 근사항을 최대화하는 것은 곧 각 비트의 평균 사용률 $\bar{p}_i$를 1/2로 미는 일입니다. 지난 글에서 진단 지표로 관찰했던 비트 균형이, BSQ에서는 근사를 거쳐 목적 함수 그 자체가 된 셈입니다. 이렇게 두 항을 모두 비트별 합으로 바꾸면, 원 논문의 표현을 빌리자면 엔트로피 계산의 복잡도가 $O(2^d \times d)$에서 $O(d)$로 내려가고, 근사 오차와 그로 인한 성능 저하는 실전에서 무시할 만한 수준이라고 보고됩니다.
물론 대가도 정직하게 명시해야 합니다. 주변부만 보는 근사이므로, 각 비트가 개별적으로는 완벽히 균형이어도 비트들끼리 강하게 상관되어 결합 분포가 좁아지는 형태의 붕괴는 원리상 잡아내지 못합니다. 예컨대 살아 있는 여섯 개의 비트가 $2^6 = 64$개 조합을 고르게 쓰고 있는지와 같은 결합 구조는, 비트별 주변부 균형만으로는 보증되지 않는 성질입니다. 이 트레이드오프가 우리의 작은 실험에서 실제로 어떤 모습으로 나타나는지는 7절에서 확인하겠습니다.
구현은 몇 줄이면 됩니다. 2절의 최소 골격에 다음을 더하면 BSQ 클래스가 완성됩니다.
def forward(self, z):
    u  = F.normalize(z, dim=-1)                   # 단위 초구 사영
    q  = torch.where(u > 0, torch.ones_like(u),
                     -torch.ones_like(u)) * self.inv_sqrt_d
    uq = u + (q - u).detach()                     # sign_ste
    aux = z.new_zeros(())
    if self.training and self.entropy_w > 0:
        flat = u.reshape(-1, self.dim)
        # 비트별 소프트 확률: q(c_i = +1/√d | u_i) = σ(4τ u_i / √d)
        p = torch.sigmoid(4.0 * self.inv_temp * flat * self.inv_sqrt_d)
        per_sample = self._bit_entropy(p).sum(-1).mean()   # E[H(q)]  : 정확 (곱분포)
        batch_ent  = self._bit_entropy(p.mean(0)).sum()    # H(E[q]) : 독립 근사(상계)
        aux = self.entropy_w * (per_sample - self.gamma * batch_ent)
    return uq, aux
self.codebook 같은 꼭짓점 목록이 코드 어디에도 없다는 점을 눈여겨보시기 바랍니다. LFQ는 엔트로피 계산을 위해 $2^d$개 꼭짓점을 상수 목록으로나마 들고 다녀야 했지만, BSQ는 그 목록조차 필요 없습니다.
그렇다면 비용 차이는 실제로 얼마나 벌어질까요. 같은 개수의 잠재 벡터에 대해 두 방식의 엔트로피 항 계산 시간을 $d = 9$부터 18까지 재 보았습니다. 전체 열거 쪽은 지난 글의 LFQ 구현과 같은 방식(꼭짓점 전체와의 거리 $\to$ softmax $\to$ 두 엔트로피 항)이고, 인수분해 쪽은 위의 BSQ 방식입니다. 측정 스크립트(entropy_bench.py)는 글 끝에 첨부했으며, 잠재 벡터 2,048개를 기준으로 순전파 계산 시간만 잽니다. 절대 수치는 하드웨어에 따라 달라지므로, 눈여겨볼 것은 두 곡선의 기울기입니다.
device: NVIDIA GeForce RTX 4070 SUPER | 잠재 벡터 N = 2048
  d |  어휘 2^d | 전체 열거(ms) | 피크 메모리(MB) | 인수분해(ms)
  9 |       512 |         0.173 |            24.3 |       0.2135
 10 |     1,024 |         0.157 |            40.3 |       0.2178
 11 |     2,048 |         0.266 |            72.4 |       0.1954
 12 |     4,096 |         0.990 |           136.5 |       0.1931
 13 |     8,192 |         2.565 |           264.7 |       0.1999
 14 |    16,384 |         5.120 |           521.2 |       0.2119
 15 |    32,768 |        10.230 |          1034.2 |       0.2608
 16 |    65,536 |        19.932 |          2060.4 |       0.2374
 17 |   131,072 |        42.020 |          4112.9 |       0.2580
 18 |   262,144 |        88.269 |          8218.4 |       0.2306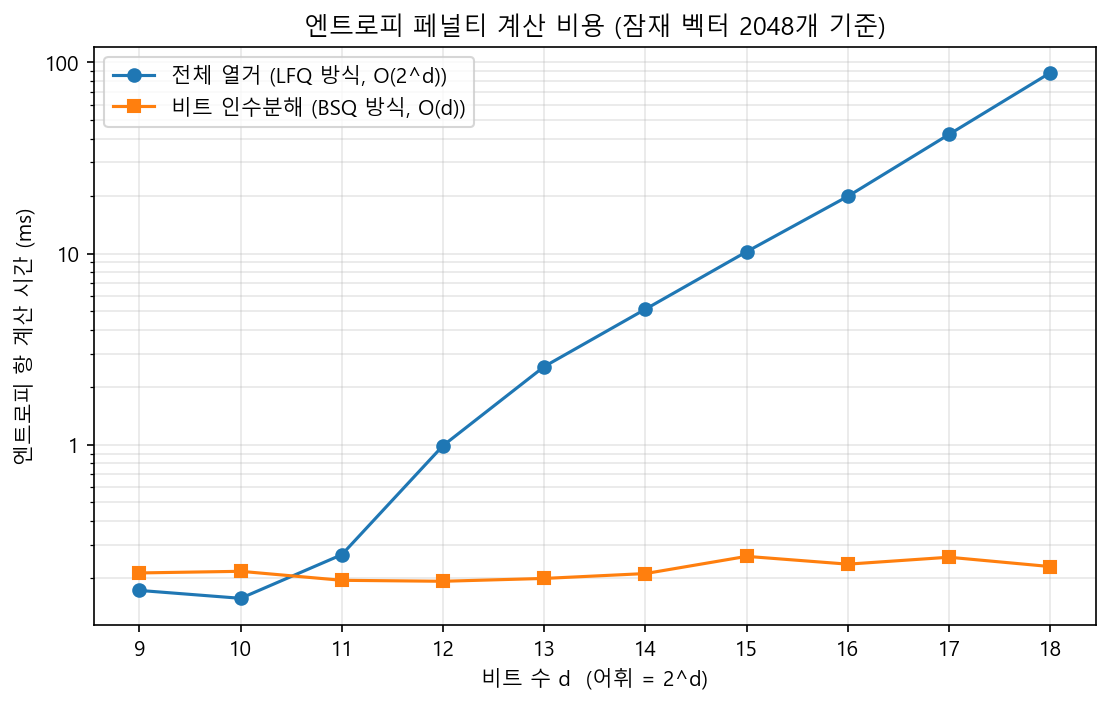
두 곡선의 기울기가 정확히 갈립니다. 전체 열거는 $d = 13$을 지나면서 비트 하나가 늘 때마다 시간이 두 배씩 증가합니다. 2.565 ms에서 5.120, 10.230, 19.932, 42.020을 거쳐 88.269 ms에 이르는 궤적이며, 피크 메모리는 그보다 더 정확하게 264.7 MB에서 8,218.4 MB까지 매 비트 2.00배씩 불어납니다. 반면 인수분해는 전 구간에서 0.19~0.26 ms 사이에 머물러, 어휘가 512에서 262,144로 512배 늘어나는 동안 계산 시간이 사실상 변하지 않습니다. $d = 18$에서 두 방식의 차이는 383배입니다.
예상과 달랐던 지점도 정직하게 적어 두겠습니다. 첫째, $d = 9$와 $d = 10$에서는 오히려 전체 열거 쪽이 더 빨랐습니다(0.173 ms 대 0.2135 ms). 어휘가 작을 때는 행렬 연산 자체가 워낙 가벼워 GPU 커널 실행 오버헤드가 지배하는데, 인수분해 쪽은 시그모이드와 엔트로피 계산이 여러 개의 작은 원소별 연산으로 나뉘어 있어 그 오버헤드를 비슷하게 치르기 때문입니다. 두 곡선이 교차하는 지점은 $d = 11$ 부근입니다. 이는 512 어휘에서는 엔트로피 계산 비용이 사실상 문제가 되지 않는다는 1절의 서술을 예상보다 더 강하게 뒷받침합니다. 인수분해가 사 오는 것은 언제나 더 빠르다는 약속이 아니라, 어휘가 커져도 비용이 늘지 않는다는 확장성입니다.
둘째, $d = 18$에서도 메모리 부족(OOM)은 발생하지 않았습니다. 여기서 기준으로 삼는 12GB는 이 실험에 사용한 GPU의 메모리 용량입니다. 콘솔 출력 첫 줄에 찍힌 대로 측정은 NVIDIA GeForce RTX 4070 SUPER에서 이루어졌고, 이 카드의 VRAM이 12GB입니다. 전체 열거의 피크 메모리는 $d = 18$에서 8,218.4 MB로, 이 12GB 안에 아슬아슬하게 들어왔습니다. 다만 이 벤치마크는 잠재 벡터 2,048개를 한 번에 처리한 것으로, 실제 학습 한 스텝이 다루는 12,544개 위치(배치 $256 \times 7 \times 7$ 격자)에 비하면 6분의 1 규모입니다. 같은 비율로 환산하면 피크 메모리는 50GB에 육박해 이 GPU로는 감당할 수 없으며, 1절에서 어림했던 메모리 벽이 측정으로 확인되는 셈입니다. 물론 절대적인 수치는 GPU마다 다르지만, 어휘가 커질수록 메모리가 비트당 두 배씩 불어난다는 추세 자체는 장비와 무관합니다.
5. BSQ가 태어난 집, BSQ-ViT: 트랜스포머 토크나이저
실험으로 넘어가기 전에, BSQ가 어떤 시스템의 심장으로 설계되었는지 잠시 보겠습니다. 원 논문이 제안하는 것은 BSQ-ViT라는 이미지·비디오 통합 토크나이저입니다. 지금까지 다뤄 온 토크나이저들이 합성곱 기반이었던 것과 달리, BSQ-ViT는 인코더와 디코더를 모두 비전 트랜스포머(ViT)로 구성하고, 블록 단위 인과 마스킹(Block-wise Causal Masking)으로 현재와 과거 시점의 토큰만 참조하게 만들어 이미지와 가변 길이 비디오를 하나의 구조로 처리합니다. 학습은 VQGAN 글에서 본 그 틀, 즉 지각 손실과 적대적 손실을 포함한 VQGAN 프레임워크에 BSQ 병목을 끼워 넣어 처음부터 끝까지(end-to-end) 이루어집니다.
수치를 보기 전에 지표를 먼저 짚겠습니다. FID(Fréchet Inception Distance)는 원본 이미지 집합과 비교 대상 이미지 집합을 각각 사전학습된 인식망에 통과시킨 뒤, 그렇게 얻은 특징 벡터들의 평균과 공분산으로 두 분포를 근사하고 그 사이의 거리를 재는 지표입니다. 두 분포가 완전히 겹치면 0이고 멀어질수록 값이 커지므로 낮을수록 좋습니다. 화소별 차이만 보는 MSE와 달리 인식망이 뽑아낸 특징의 통계를 비교하기 때문에, 사람이 느끼는 품질에 더 가깝게 움직인다는 것이 널리 쓰이는 이유입니다. 여기서 말하는 복원 FID는 새로 생성한 이미지가 아니라 토크나이저가 압축했다 되살린 이미지를 원본과 견주는 것이므로, 양자화 병목이 정보를 얼마나 잃는지를 직접 재는 셈입니다. FVD(Fréchet Video Distance)는 같은 계산을 비디오로 옮긴 것으로, 정지 영상 인식망 대신 시간축까지 함께 보는 영상 인식망의 특징을 쓰기 때문에 프레임 하나하나의 화질뿐 아니라 움직임의 자연스러움까지 함께 반영합니다.
성과는 세 방면에서 보고됩니다. 첫째, 복원입니다. 논문은 ImageNet-1k 검증셋에서 복원 FID 0.41을 달성해 차점자였던 SDXL의 VAE보다 43% 낮은 수치를 2.4배의 처리량으로 얻었고, 비디오 쪽에서는 UCF-101 복원 FVD를 8.62에서 4.10으로 절반 이하로 줄였다고 보고합니다. 둘째, 압축입니다. 토큰 위에 자기회귀 사전 분포를 학습시켜 적응 산술 부호화(Adaptive Arithmetic Coding)와 결합하면, H.264나 HEVC 같은 표준 비디오 코덱과 견줄 만한 압축 성능이 나온다는 것입니다. 토크나이저가 국소적인 손실 압축을 맡고 가벼운 시퀀스 모델이 전역 구조를 압축하는 이 구도는, 신호 처리를 다뤄 온 입장에서 특히 흥미로운 결과입니다. 셋째, 생성입니다. 이 토큰 위에 마스크 언어 모델을 얹으면 BigGAN이나 ADM 같은 GAN·확산 기반 방법에 견줄 만한 이미지 생성 품질이 나온다고 보고합니다. LFQ 글에서 MAGVIT-v2를 통해 보았던, 생성 품질의 상당 부분이 결국 토크나이저의 설계에 달려 있다는 교훈이 여기서도 반복되는 셈입니다.
계보도 이미 이어지고 있습니다. 대표적인 후속이 ByteDance의 텍스트-이미지 생성 모델 Infinity입니다. Infinity는 다중 스케일 잔차를 비트 단위로 양자화하는 토크나이저를 세우면서 그 양자화기로 BSQ를 채택했고, 학습되는 코드북이 없다는 성질 덕분에 어휘를 $2^{64}$ 규모까지 키우는 비트 단위 자기회귀 생성을 실현했습니다. $2^{64}$는 명시적 코드북으로는 저장조차 불가능한 크기입니다. 비트가 곧 토큰이라는 LFQ의 노선이, BSQ의 구면 위에서 어디까지 뻗어 나갔는지 보여 주는 사례입니다.
6. 비교 실험 설계: 코드북 512로 맞춘 BSQ vs LFQ
이제 지난 글들과 같은 방식으로, 공정한 비교를 위한 원칙을 세우고 직접 학습시켜 보겠습니다.
- 인코더·디코더 구조는 완전히 동일하게 유지하고, 병목(Bottleneck)만 교체합니다. 지난 두 글과 같은 설계로, $28 \times 28$ 입력을 stride-2 합성곱 2회로 줄인 $7 \times 7$ 잠재 격자를 사용합니다.
- 코드북 크기를 정확히 맞춥니다. BSQ와 LFQ 모두 $d = 9$로 $2^9 = 512$입니다.
- 각 방식의 표준 구성을 따릅니다. LFQ는 지난 글 그대로 커밋먼트($\beta = 0.25$)와 전체 열거 엔트로피 페널티($\lambda_e = 0.1, \gamma = 1$, 역온도 100)를 갖추고, BSQ는 3절에서 설명한 대로 커밋먼트 없이 인수분해 엔트로피 페널티($\lambda_e = 0.1, \gamma = 1$)만 둡니다. 다만 구면 위에서는 $\vert{}u_i\vert{}$가 $1/\sqrt{d}$ 수준으로 작아 로짓의 스케일이 달라지므로, BSQ의 역온도는 10으로 낮춰 잡았습니다(별도 조율은 하지 않은 값입니다).
- BSQ는 두 버전을 함께 둡니다. 위의 온전한 BSQ와, 엔트로피 페널티마저 뗀 BSQ-무페널티($\lambda_e = 0$)입니다. 후자는 보조 손실이 문자 그대로 0인 구성으로, FSQ 이후 처음 다시 등장하는 완전 무보조 양자화기입니다. 던지는 질문은 이것입니다. 축당 레벨이 2뿐인 부호 양자화에서도, 구면 사영만으로 붕괴를 피할 수 있는가.
- 데이터와 학습 설정은 지난 글과 같습니다. MNIST 학습 이미지 20,000장, 검증은 테스트 집합 10,000장, 배치 256, Adam 학습률 0.001, 15 에폭, 세 모델 동일 시드입니다. 특히 이번에는 세 병목 모두 학습 파라미터가 하나도 없으므로, 세 모델은 파라미터 수가 같은 것을 넘어 인코더·디코더의 초기 가중치까지 완전히 동일한 상태에서 출발합니다.
- 관찰 대상은 (1) 에폭별 코드북 활용도(perplexity)와 활성 코드 수, (2) 검증셋 복원 손실(MSE), (3) 비트별 +1 사용 비율, 그리고 이번 글 고유의 관찰인 (4) 평균 양자화 오차(3절의 이론 상계와 대조)입니다.
perplexity는 지난 글들과 같은 정의입니다. 코드 $k$가 선택되는 비율을 $p_k$라 할 때,
로, 코드북을 얼마나 고르게 쓰는지를 나타내며 최댓값은 코드북 크기 512입니다.
한 가지 미리 밝혀 둘 점도 지난 글과 같습니다. 이번 스크립트는 지난 글의 첨부 코드와 세부 구성이 완전히 같지는 않을 수 있으므로, LFQ의 절대 수치가 지난 글과 다르게 나올 수 있습니다. 글 사이의 수치 비교보다는 같은 조건 안에서의 세 방식 비교가 이 실험의 목적입니다. 전체 코드는 글 끝에 첨부했으며(bsq_vs_lfq.7z), PyTorch와 numpy, matplotlib만 있으면 MNIST를 자동으로 내려받아 그대로 실행됩니다.
python bsq_vs_lfq.py
7. 직접 확인하기: 활용도, 복원 품질, 비트 균형, 그리고 오차
세 모델의 학습 로그부터 보겠습니다. 병목에 학습 파라미터가 없으므로 파라미터 수는 세 모델 모두 인코더·디코더의 109,450개로 동일합니다.
### BSQ 학습 시작 (parameters: 109,450) ###
[BSQ         ] epoch  1 | val_loss 0.04399 | perplexity    2.9/512 | active 424/512
[BSQ         ] epoch  2 | val_loss 0.03794 | perplexity    2.9/512 | active 395/512
[BSQ         ] epoch  3 | val_loss 0.03206 | perplexity    3.2/512 | active 380/512
[BSQ         ] epoch  4 | val_loss 0.02848 | perplexity    3.4/512 | active 372/512
[BSQ         ] epoch  5 | val_loss 0.02675 | perplexity    3.4/512 | active 411/512
[BSQ         ] epoch  6 | val_loss 0.02525 | perplexity    3.6/512 | active 400/512
[BSQ         ] epoch  7 | val_loss 0.02413 | perplexity    3.5/512 | active 399/512
[BSQ         ] epoch  8 | val_loss 0.02326 | perplexity    3.6/512 | active 352/512
[BSQ         ] epoch  9 | val_loss 0.02260 | perplexity    3.6/512 | active 369/512
[BSQ         ] epoch 10 | val_loss 0.02184 | perplexity    3.7/512 | active 382/512
[BSQ         ] epoch 11 | val_loss 0.02069 | perplexity    3.9/512 | active 420/512
[BSQ         ] epoch 12 | val_loss 0.02055 | perplexity    3.8/512 | active 403/512
[BSQ         ] epoch 13 | val_loss 0.01968 | perplexity    3.9/512 | active 364/512
[BSQ         ] epoch 14 | val_loss 0.01959 | perplexity    3.9/512 | active 368/512
[BSQ         ] epoch 15 | val_loss 0.01902 | perplexity    4.0/512 | active 370/512

### LFQ 학습 시작 (parameters: 109,450) ###
[LFQ         ] epoch  1 | val_loss 0.03599 | perplexity   15.8/512 | active 16/512
[LFQ         ] epoch  2 | val_loss 0.02584 | perplexity   15.7/512 | active 16/512
[LFQ         ] epoch  3 | val_loss 0.02168 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch  4 | val_loss 0.01958 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch  5 | val_loss 0.01749 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch  6 | val_loss 0.01639 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch  7 | val_loss 0.01626 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch  8 | val_loss 0.01525 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch  9 | val_loss 0.01440 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch 10 | val_loss 0.01417 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch 11 | val_loss 0.01441 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch 12 | val_loss 0.01331 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch 13 | val_loss 0.01290 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch 14 | val_loss 0.01286 | perplexity   15.9/512 | active 16/512
[LFQ         ] epoch 15 | val_loss 0.01263 | perplexity   15.9/512 | active 16/512

### BSQ-무페널티 학습 시작 (parameters: 109,450) ###
[BSQ-무페널티] epoch  1 | val_loss 0.01602 | perplexity  144.6/512 | active 495/512
[BSQ-무페널티] epoch  2 | val_loss 0.01066 | perplexity  220.7/512 | active 512/512
[BSQ-무페널티] epoch  3 | val_loss 0.00892 | perplexity  242.6/512 | active 512/512
[BSQ-무페널티] epoch  4 | val_loss 0.00819 | perplexity  262.2/512 | active 512/512
[BSQ-무페널티] epoch  5 | val_loss 0.00761 | perplexity  255.9/512 | active 512/512
[BSQ-무페널티] epoch  6 | val_loss 0.00748 | perplexity  245.0/512 | active 512/512
[BSQ-무페널티] epoch  7 | val_loss 0.00679 | perplexity  286.3/512 | active 512/512
[BSQ-무페널티] epoch  8 | val_loss 0.00641 | perplexity  293.4/512 | active 512/512
[BSQ-무페널티] epoch  9 | val_loss 0.00627 | perplexity  305.4/512 | active 512/512
[BSQ-무페널티] epoch 10 | val_loss 0.00596 | perplexity  299.5/512 | active 512/512
[BSQ-무페널티] epoch 11 | val_loss 0.00584 | perplexity  310.6/512 | active 512/512
[BSQ-무페널티] epoch 12 | val_loss 0.00566 | perplexity  291.7/512 | active 512/512
[BSQ-무페널티] epoch 13 | val_loss 0.00550 | perplexity  292.5/512 | active 512/512
[BSQ-무페널티] epoch 14 | val_loss 0.00542 | perplexity  309.8/512 | active 512/512
[BSQ-무페널티] epoch 15 | val_loss 0.00572 | perplexity  288.4/512 | active 512/512
에폭이 진행되는 동안 세 방식의 코드북 활용도와 복원 손실이 어떻게 갈라지는지를 그래프로 보면 다음과 같습니다.
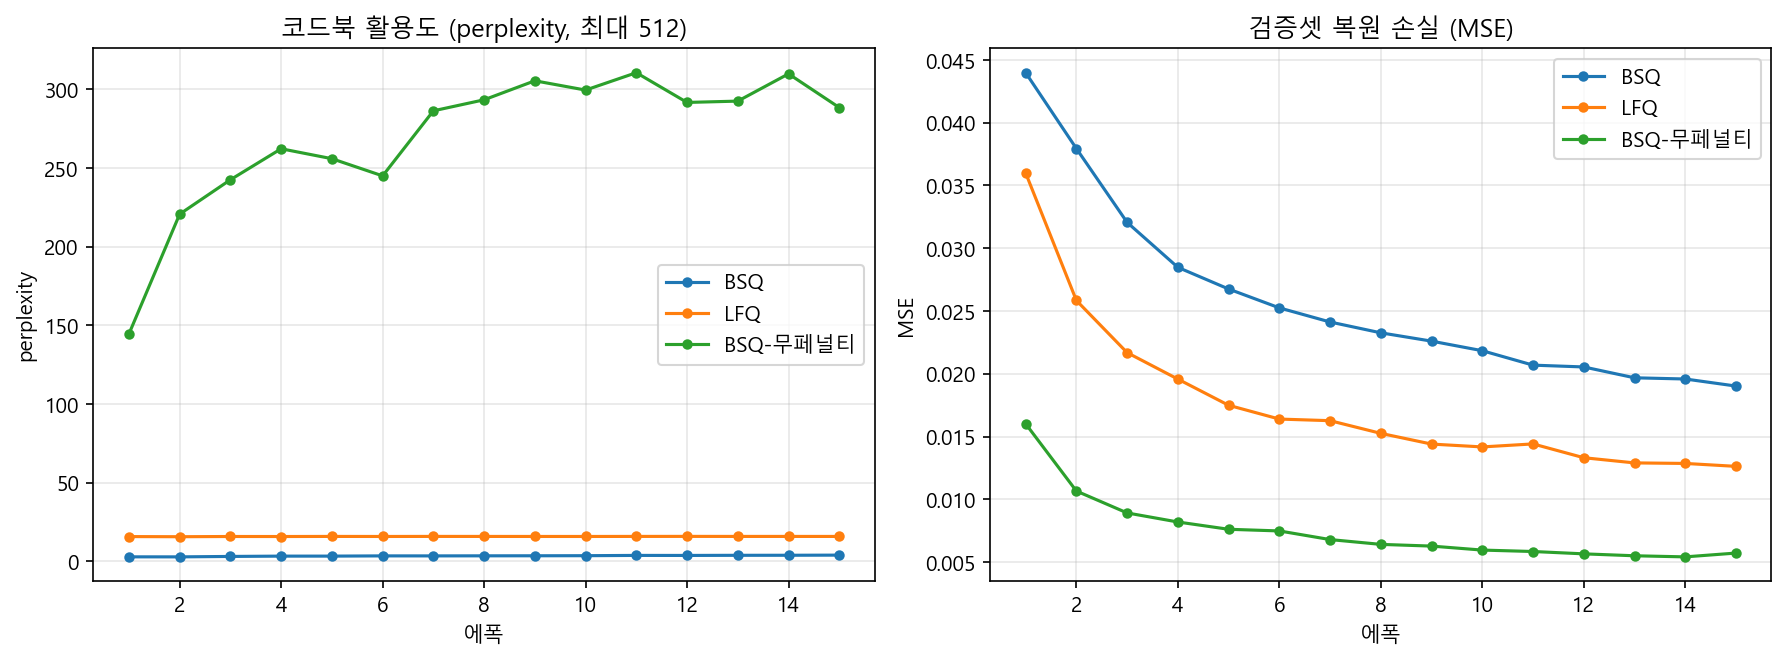
결과는 이 글을 쓰며 예상했던 것과 정반대였습니다. 세 방식의 순위를 먼저 적으면, 검증 복원 손실은 BSQ-무페널티 0.00572, LFQ 0.01263, BSQ 0.01902 순이고 코드북 활용도 역시 같은 순서입니다. 보조 손실을 완전히 비운 BSQ-무페널티가 모든 지표에서 압도적인 1위이고, 정석대로 엔트로피 페널티를 갖춘 BSQ가 꼴찌입니다.
BSQ-무페널티부터 보겠습니다. 2에폭 만에 512개 코드를 남김없이 사용하기 시작해 끝까지 512/512를 유지했고, perplexity는 288.4까지 올라갔습니다. 복원 손실도 0.00572로 나머지 둘을 두 배 이상 앞섭니다. 수렴 속도도 눈에 띕니다. 첫 에폭에서 이미 0.01602를 기록해, LFQ가 열다섯 에폭을 다 쓰고 도달한 0.01263에 근접한 자리에서 출발했습니다. 유계 양자화 오차 덕분에 학습이 쉬워지고 수렴이 빨라진다는 3절의 논문 보고가, 공교롭게도 페널티를 모두 떼어 낸 이 구성에서 가장 선명하게 확인된 셈입니다. 6절에서 던졌던 질문, 즉 축당 레벨이 2뿐인 부호 양자화에서도 구면 사영만으로 붕괴를 피할 수 있는가에 대한 답은 이 규모에서는 명확히 "그렇다"입니다. 보조 손실이 문자 그대로 0인 양자화기가 코드북을 완전히 활용한 것은 FSQ 이후 처음 보는 장면입니다.
LFQ는 전형적인 부분 붕괴를 보입니다. 활성 코드가 첫 에폭부터 16개로 고정되어 끝까지 변하지 않았고, perplexity 15.9는 그 16개를 거의 균등하게 쓰고 있다는 뜻입니다. 512개 어휘 중 3%만 살아남은 셈이지만, 그 16개를 알뜰하게 써서 복원 손실 자체는 BSQ보다 나았습니다.
가장 뜻밖인 것은 BSQ입니다. 활성 코드는 370개로 셋 중 중간인데 perplexity는 4.0에 불과합니다. 370개 코드가 최소 한 번씩은 등장하지만 실제 사용 분포가 극도로 편중되어, 유효하게 쓰이는 코드가 네 개 남짓이라는 뜻입니다. 활성 코드 수와 perplexity가 이렇게 크게 어긋나는 것은 지금까지의 실험에서 보지 못한 형태이고, 그 원인은 비트별 사용 비율을 볼 때 드러납니다. 복원 손실도 0.01902로 가장 나빠, 엔트로피 페널티가 활용도를 높이기는커녕 오히려 표현력을 갉아먹었습니다.
최종 에폭(15)에서의 수치를 표로 정리하면 다음과 같습니다.
| 방식 | 검증 복원 손실(MSE) | perplexity | 활성 코드 | 평균 양자화 오차 |
|---|---|---|---|---|
| BSQ | 0.01902 | 4.0 | 370 / 512 | 0.1181 |
| LFQ | 0.01263 | 15.9 | 16 / 512 | 0.6028 |
| BSQ-무페널티 | 0.00572 | 288.4 | 512 / 512 | 0.6153 |
수치로 보이는 차이가 실제 복원 이미지에서도 그대로 드러나는지 눈으로 확인해 보겠습니다.
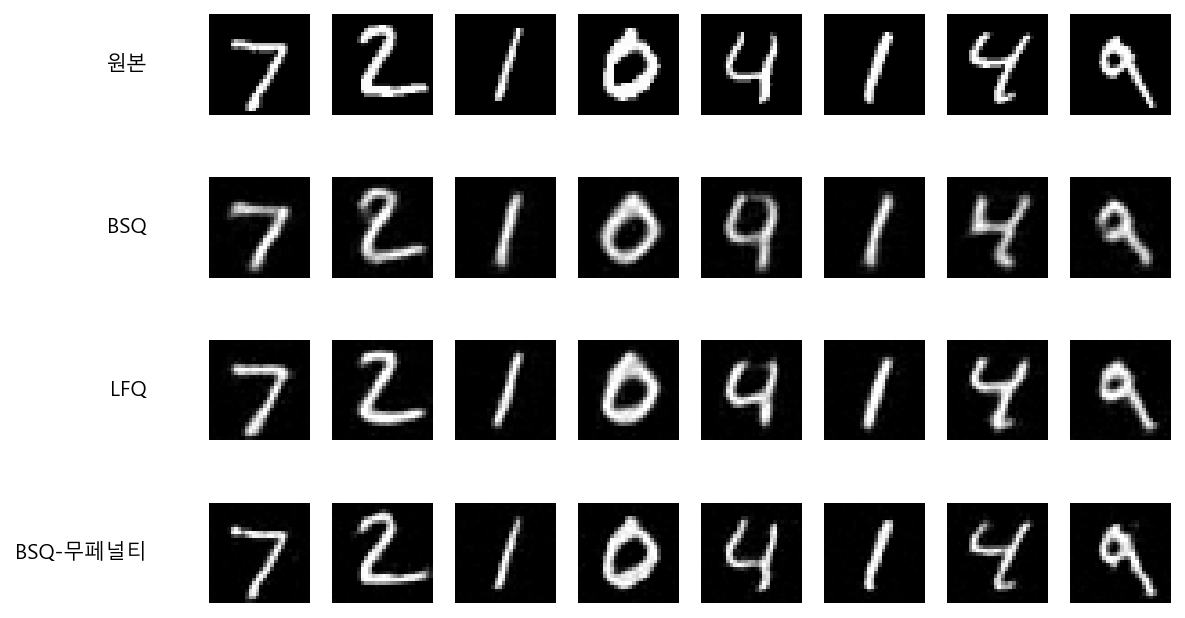
MSE 순위가 눈으로도 그대로 확인됩니다. BSQ-무페널티의 복원은 획의 굵기 변화까지 살아 있어 원본과 거의 구별되지 않고, LFQ가 그다음, BSQ가 가장 흐릿합니다. 특히 다섯 번째 숫자에서 차이가 분명합니다. 원본의 4는 위쪽이 열린 형태인데, BSQ의 복원에서는 그 틈이 메워져 9에 가깝게 보입니다. 유효 코드가 네 개 남짓인 상태에서는 비슷한 숫자들을 같은 토큰으로 뭉뚱그릴 수밖에 없다는 것이 그림으로 드러난 셈입니다.
한편 LFQ의 복원은 512개 중 16개 코드만 쓰고 있다는 사실이 무색할 만큼 멀쩡합니다. 코드북 붕괴의 대가는 복원 화면만 봐서는 좀처럼 드러나지 않는다는 점, 그래서 활용도 지표를 따로 봐야 한다는 점이 이번에도 반복됩니다. 다만 이번에는 그 반대 방향의 교훈이 하나 더해집니다. 활성 코드 수만 보면 BSQ가 370개로 LFQ의 16개를 크게 앞서지만, 실제 복원 품질은 BSQ가 더 나쁩니다. 활성 코드 수는 코드가 한 번이라도 쓰였는지만 세기 때문에, perplexity와 함께 보지 않으면 이렇게 정반대의 인상을 줄 수 있습니다.
다음은 지난 글에서 도입한 진단 지표, 비트별 +1 사용 비율입니다. 이번에는 세 모델을 나란히 놓았습니다.
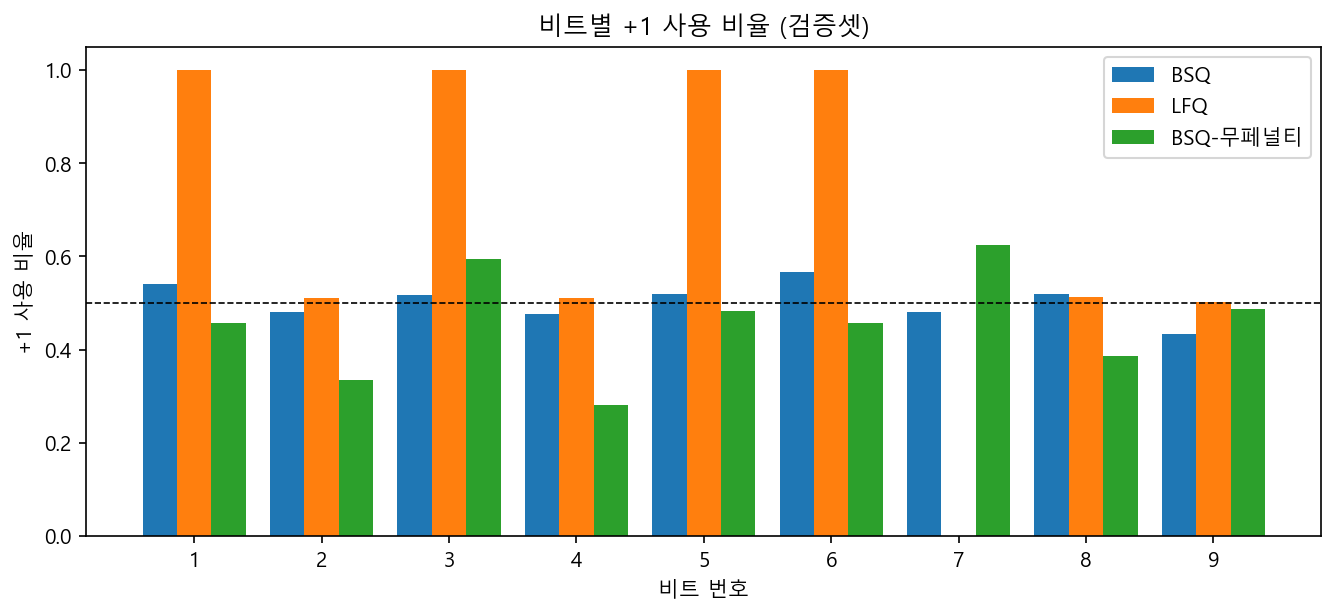
--- 검증셋 비트별 +1 사용 비율 / 양자화 오차 ---

BSQ 비트별 +1 사용 비율: [0.524 0.476 0.523 0.479 0.522 0.559 0.476 0.523 0.479]
BSQ 평균 편차 |p-0.5| = 0.027
BSQ 평균 양자화 오차 ||u-û|| = 0.1181 | 최대 1.0735 | 이론 상계 1.1547

LFQ 비트별 +1 사용 비율: [1.    0.501 1.    0.503 1.    1.    0.    0.531 0.488]
LFQ 평균 편차 |p-0.5| = 0.283
LFQ 평균 양자화 오차 ||z-q|| = 0.6028 | 최대 2.3867 | (상계 없음)

BSQ-무페널티 비트별 +1 사용 비율: [0.435 0.304 0.535 0.262 0.422 0.425 0.589 0.378 0.428]
BSQ-무페널티 평균 편차 |p-0.5| = 0.108
BSQ-무페널티 평균 양자화 오차 ||u-û|| = 0.6153 | 최대 1.0789 | 이론 상계 1.1547
이 표가 앞의 수수께끼를 풉니다. 먼저 LFQ는 해석이 간단합니다. 1·3·5·6번 비트가 항상 $+1$로, 7번 비트가 항상 $-1$로 얼어붙어 다섯 개가 죽었고, 살아남은 것은 2·4·8·9번의 네 개뿐입니다. 네 개의 비트가 만들 수 있는 조합은 $2^4 = 16$이고, 이것이 활성 코드 16개와 정확히 일치합니다. perplexity 15.9는 그 16개를 거의 균등하게 쓰고 있다는 뜻이므로, LFQ의 상태는 "9비트 중 4비트만 살아 있는 코드북"이라고 한 문장으로 요약됩니다.
BSQ는 정반대입니다. 얼어붙은 비트가 하나도 없고, 아홉 개 비트의 $+1$ 비율이 모두 0.476에서 0.559 사이에 들어 있습니다. 평균 편차 0.027은 세 방식 중 가장 낮은, 사실상 완벽한 균형입니다. 4절에서 배치 항의 정체를 각 비트의 평균 사용률을 1/2로 미는 힘이라고 했는데, 그 힘은 의도한 대로 정확히 작동한 것입니다.
문제는 그렇게 얻은 비트 균형이 코드북 활용도로 이어지지 않았다는 점입니다. perplexity를 비트 단위로 환산하면 상황이 선명해집니다. $\log_2(\text{perplexity})$는 실질적으로 몇 비트어치의 정보가 토큰에 실려 있는지를 나타내는데, LFQ는 $\log_2 15.9 = 3.99$로 살아 있는 비트 수 4와 정확히 맞아떨어지고, BSQ-무페널티는 $\log_2 288.4 = 8.17$로 아홉 비트 중 여덟 비트 남짓을 쓰고 있습니다. 그런데 BSQ는 $\log_2 4.0 = 2.0$, 즉 아홉 개의 비트가 모두 살아 있고 각각이 완벽히 균형인데도 실효 정보량은 두 비트뿐입니다. 나머지 일곱 비트어치는 비트들 사이의 상관으로 사라졌습니다.
이것이 4절에서 대가로 지목했던 바로 그 실패입니다. 비트 독립을 가정한 페널티는 각 비트의 주변부 분포만 보므로, 개별 비트가 아무리 고르게 쓰여도 비트들이 서로 묶여 움직이는 상황은 감지하지 못합니다. BSQ의 비율 배열을 다시 보면 그 흔적이 보입니다. 1·3·5·8번이 나란히 0.52 부근, 2·4·7·9번이 나란히 0.48 부근으로 두 무리를 이루는데, 이는 비트들이 개별적으로 움직이지 않고 무리 단위로 함께 뒤집히고 있음을 시사합니다. 주변부 통계만 보는 페널티에게 이런 코드북은 나무랄 데 없이 건강해 보입니다.
4절에서 원 논문의 보고를 인용하며, 이 근사가 낳는 오차와 성능 저하는 실전에서 무시할 만한 수준이라고 적었습니다. 우리의 실험은 그 문장을 정면으로 마주하게 만듭니다. 코드북 512라는 작은 무대에서, 조율하지 않은 페널티 설정으로 돌린 이번 실행에서는 그 대가가 무시할 만하기는커녕 결과를 가르는 결정적 요인이었습니다. 두 진술이 모순되는 것은 아닙니다. 논문의 보고는 대규모 어휘와 충분히 조율된 설정에서 얻은 것이고, 애초에 이 근사가 필요해지는 무대도 그쪽입니다. 다만 논문의 결론을 조건 없이 옮겨 적는 것과, 그 조건이 무엇이었는지 알고 옮겨 적는 것은 다릅니다. 근사에는 언제나 그것이 성립하는 영역이 있고, 그 영역 밖에서는 이렇게 뚜렷한 흔적을 남긴다는 사실을 이번 실험이 보여 줍니다.
BSQ-무페널티가 흥미로운 대조를 이룹니다. 평균 편차 0.108로 균형 자체는 BSQ보다 나쁘고 비율도 0.262에서 0.589까지 흩어져 있지만, 얼어붙은 비트가 없고 비트끼리 묶이지도 않아 512개 코드를 남김없이 씁니다. 주변부 균형과 결합 분포의 다양성은 별개의 성질이며, 실제로 쓸모 있는 쪽은 후자라는 것을 이 대비가 보여 줍니다.
왜 페널티가 오히려 상관을 키웠는지는 양자화 오차가 단서를 줍니다. BSQ의 평균 오차 0.1181은 무페널티의 0.6153에 비해 다섯 배 이상 작습니다. 3절의 데모에서 표준정규 방향을 $d = 9$로 사영했을 때의 평균 오차가 0.590이었음을 떠올리면(그 절의 표에서 $d = 9$ 행), 무페널티 쪽이 오히려 그 자연스러운 값에 가깝고 BSQ의 잠재 벡터는 꼭짓점에 지나치게 밀착해 있다는 뜻입니다. 엔트로피 페널티의 표본별 항, 즉 각 입력이 하나의 코드에 확신을 가지라는 항이 인코더 출력을 소수의 꼭짓점 쪽으로 강하게 끌어당겼고, 그 대가로 방향의 다양성을 잃은 것으로 보입니다.
다만 이 결과를 BSQ 방식 자체의 실패로 읽어서는 곤란합니다. 6절에서 밝혔듯 페널티 가중치 $\lambda_e = 0.1$과 역온도 10은 별도 조율 없이 잡은 값이고, 특히 역온도는 구면 위에서 로짓 스케일이 달라지는 것을 감안해 눈대중으로 낮춘 값입니다. 표본별 항과 배치 항의 균형을 다시 잡거나 페널티를 약하게 걸면 다른 그림이 나올 여지가 충분합니다. 이 실험이 말해 주는 것은 BSQ가 나쁘다는 것이 아니라, 비트 독립 근사가 치르는 대가가 이론상의 각주가 아니라 실제로 관측되는 현상이라는 사실입니다.
마지막으로 이번 글 고유의 관찰인 양자화 오차 실측입니다. 위의 콘솔 출력 마지막 줄들이 학습된 모델의 검증셋 평균·최대 오차이며, BSQ의 이론 상계 $\sqrt{4/3} \approx 1.155$와 나란히 인쇄됩니다.
이 대목은 이번 글의 이론이 가장 깨끗하게 확인되는 지점입니다. BSQ와 BSQ-무페널티의 최대 오차는 각각 1.0735와 1.0789로, 둘 다 이론 상계 1.1547 아래에 있습니다. 학습이 어떻게 진행되었든, 인코더가 어떤 출력을 내놓든 오차가 이 선을 넘을 수 없다는 3절의 유도가 실측으로 확인된 것입니다. 코드북 활용도에서는 두 모델의 운명이 극과 극으로 갈렸는데도 최대 오차만은 나란히 상계 바로 아래에 머문다는 점이 오히려 인상적입니다. 이것은 학습으로 얻어 낸 성질이 아니라 구조가 보장하는 성질이기 때문입니다.
LFQ는 대조적입니다. 최대 오차 2.3867은 BSQ의 상계 1.1547의 두 배가 넘고, 3절에서 어떤 차원에서도 BSQ가 넘을 수 없다고 했던 $\sqrt{2} \approx 1.414$조차 훌쩍 넘어섭니다. 커밋먼트 손실이 평균 오차를 0.6028 수준으로 관리하고는 있지만, 그것은 손실 항이 매 스텝 밀어 주어 유지되는 평균일 뿐 개별 표본의 오차에 대해서는 아무것도 보장하지 못합니다. 3절에서 손실 항으로 유지하는 성질과 구조가 보장하는 성질의 차이라고 했던 대비가, 학습이 끝난 실제 모델에서 그대로 재현된 셈입니다.
8. VQ, FSQ, LFQ, BSQ — 무엇을 선택할 것인가
네 번째 양자화기까지 살펴봤으니, 양자화기 지도를 다시 그려 보겠습니다.
VQ(벡터 양자화)는 여전히 표현력의 기준점입니다. FSQ 글에서 세 겹의 장치를 제대로 손질한 VQ-EMA는 복원 손실 0.00271로 최저를 기록했고, VQGAN을 비롯한 거대한 사전학습 생태계가 그 위에 서 있습니다. 다만 그 성능에 도달하기까지 코드북 크기가 바뀔 때마다 함께 점검해야 하는 장치들이 따라온다는 것을 우리는 직접 겪었습니다.
FSQ는 미니멀리즘의 극단입니다. 축당 레벨을 넉넉히 두는 대신 보조 손실을 완전히 비운 유일한 선택지로, 중간 규모 어휘에서 가장 단순하고 검증된 출발점이라는 위상은 그대로입니다.
LFQ는 어휘 확장성의 문을 연 쪽입니다. 축당 레벨을 2까지 줄여 비트 하나로 어휘를 두 배씩 불리는 자유를 얻었고, 그 대가로 엔트로피 페널티라는 장치 하나와, 어휘에 비례하는 그 계산 비용, 그리고 상한 없는 양자화 오차를 안았습니다.
BSQ는 그 LFQ의 노선을 그대로 이으면서 청구서를 정리한 후속입니다. 정규화 한 단계로 오차에 상한을 만들어 커밋먼트를 지웠고, 구면이 만들어 주는 인수분해로 엔트로피 비용을 $O(2^d)$에서 $O(d)$로 내렸습니다. 비트가 곧 토큰이라는 확장성은 그대로이므로, 초대형 어휘가 필요한 자리에서는 BSQ가 현재 가장 정돈된 선택지입니다. 원 논문의 BSQ-ViT가 복원·압축·생성에서 보인 결과, 그리고 Infinity가 $2^{64}$ 어휘까지 밀어붙인 사례가 그 실효성을 증언합니다. 반대로 어휘가 수백~수천 규모라면 굳이 비트까지 쪼갤 이유가 없고, FSQ의 넉넉한 레벨이나 잘 손질된 VQ가 여전히 유효한 체급입니다.
| 기준 | VQ | FSQ | LFQ | BSQ |
|---|---|---|---|---|
| 코드북 형태 | 학습되는 임베딩 표 | 고정 격자 (축당 레벨 Li) | 초입방체 꼭짓점 {±1}d | 구에 내접한 꼭짓점 {±1/√d}d |
| 병목 학습 파라미터 | 있음 (K×d 표) | 없음 | 없음 | 없음 |
| 보조 손실 | 커밋먼트 + 코드북 손실 | 없음 | 커밋먼트 + 엔트로피 페널티 | 엔트로피 페널티 (커밋먼트 불필요) |
| 양자화 오차 상한 | 없음 | 있음 (격자 간격) | 없음 | 있음 (√(2 - 2/√d) < √2) |
| 엔트로피 페널티 비용 | — | — | O(2d) · 어휘 비례 | O(d) · 비트 수 비례 |
| 어휘 확장성 | 제한적 | 중간 | 높음 | 높음 |
여기에 이번 실험이 몇 장면을 보탭니다.
첫 장면은 보조 손실을 완전히 비운 BSQ가 512 어휘를 남김없이 쓰며 가장 좋은 복원을 냈다는 것입니다. 축당 레벨이 2뿐인 부호 양자화에서도 구면 사영만으로 붕괴를 피할 수 있다면, FSQ가 열어 둔 무보조 양자화의 노선이 비트 단위까지 내려올 수 있다는 뜻이 됩니다. 물론 MNIST에 코드북 512라는 작은 무대에서 얻은 한 장면이므로 일반화는 조심해야 하지만, 적어도 구면 사영이 붕괴 압력 자체를 상당히 낮춘다는 정황은 분명합니다.
둘째 장면은 비트 독립 근사가 치르는 대가를 눈으로 보았다는 것입니다. 아홉 개 비트가 모두 완벽에 가깝게 균형을 이루면서도 실효 정보량은 두 비트에 그치는 코드북이 실제로 만들어졌습니다. 주변부만 보는 페널티에게는 아무 문제가 없어 보이는 상태입니다. $O(2^d)$를 $O(d)$로 내리는 대가가 이론상의 각주가 아니라 관측 가능한 현상이라는 점, 그리고 그렇기 때문에 비트 균형만이 아니라 perplexity를 함께 봐야 한다는 점이 이 실험이 남긴 교훈입니다.
셋째 장면은 유계 오차가 말 그대로 구조의 성질이라는 확인입니다. 활용도에서 극과 극으로 갈린 두 BSQ 모델이 최대 오차만은 나란히 이론 상계 아래에 머물렀고, 상계가 없는 LFQ는 그 두 배를 넘겼습니다. 학습이 무엇을 하든 넘을 수 없는 선이 있다는 것, 이것이 정규화 한 단계가 사온 가장 확실한 이득입니다.
마치며
디지털 데이터를 트랜스포머가 읽을 수 있는 토큰으로 바꾸는 이산화 여정은 VQ-VAE의 학습되는 코드북에서 출발해 여러 변곡점을 지나왔습니다. VQGAN이 적대적 손실로 화질을 끌어올렸고, FSQ가 거리를 계산하는 대신 고정 격자로 반올림해 구조를 덜어 냈으며, LFQ가 이를 부호 비트로 쪼개어 방대한 어휘의 기초를 다졌습니다. 그리고 오늘 BSQ는 LFQ가 남긴 지수 규모의 엔트로피 비용을, 잠재 벡터를 구면에 올려 비트별로 인수분해하는 한 수로 $O(d)$까지 끌어내렸습니다. 단계마다 무언가가 지워진 여정이기도 했습니다. 임베딩 표가 지워졌고, 조회가 지워졌고, 커밋먼트와 어휘 크기에 비례하던 엔트로피 비용이 지워졌으며, 마지막으로 잠재 벡터의 크기 그 자체가 지워졌습니다. 남은 것은 방향과 부호뿐입니다.
공교롭게도 이번 실험이 그 목록에 한 줄을 더 얹었습니다. 우리의 작은 무대에서 가장 좋은 결과를 낸 것은 엔트로피 페널티마저 지워 버린 구성이었습니다. 물론 MNIST와 512 어휘라는 조건에서 얻은 한 장면이고, 논문이 겨냥하는 초대형 어휘의 무대에서는 그 페널티가 여전히 제 몫을 할 것입니다. 다만 무엇을 지울 수 있는지 묻는 일이 이 계보를 여기까지 끌고 왔다면, 그 질문은 아직 끝나지 않은 셈입니다.
신호 처리를 오래 다뤄 온 입장에서 이 마지막 그림에는 낯익은 데가 있습니다. 크기를 정규화해 에너지를 고정한 뒤 각 성분을 1비트로 읽는 것은, AGC 뒤에 1비트 양자화기를 붙인 구도이자 진폭을 버리고 부호(위상)만 남기는 일정 포락선 신호의 감각이기도 합니다. LFQ가 이미 축당 1비트 양자화에 가까웠다면, BSQ는 거기에 정규화 한 단을 앞세워 그 회귀를 마무리한 셈입니다. 양자화기는 더 단순해지기 어려울 만큼 단순해졌고, 그 단순한 꼭짓점에 무엇을 실을지를 궁리하는 몫은 온전히 인코더와 디코더로 넘어갔습니다.
PixelCNN의 픽셀 위 자기회귀에서 시작해 VQGAN의 선명한 토큰, FSQ의 고정 격자, LFQ의 비트, 그리고 BSQ의 구면까지, 생성 모델 심화편으로 계획했던 다섯 정거장을 모두 지나왔습니다. 돌아보면 이 여정은 코드북을 무겁게 학습시켜 붕괴를 막으려 애쓰던 자리에서, 잠재 공간의 기하학 그 자체에 표현을 맡기는 자리로 옮겨 온 과정이었습니다. 명시적인 표를 들고 다니던 손을 놓자 어휘는 비트가 허락하는 만큼 넓어졌고, 무엇을 지울 수 있는가라는 물음은 매번 더 단순하고 더 견고한 구조로 우리를 데려다주었습니다. 그러나 부호와 방향만 남은 이 꼭짓점들이 끝은 아닙니다. 구면 위의 코드 배치를 더 촘촘한 최밀 격자로 바꾸려는 시도처럼, BSQ가 열어젖힌 구면 위에서 다음 장은 이미 쓰이고 있습니다. 픽셀에서 토큰으로, 토큰에서 비트로, 비트에서 구면으로 이어진 이 다섯 편의 이야기가, 지금 이 순간에도 갱신되는 그 지도 위에서 다음 좌표를 찾는 이들에게 쓸 만한 밑그림으로 남기를 바랍니다.
📖 참고문헌
- Zhao, Y., Xiong, Y., & Krähenbühl, P. (2024).
Image and Video Tokenization with Binary Spherical Quantization.
arXiv preprint. https://arxiv.org/abs/2406.07548 - Yu, L., Lezama, J., Gundavarapu, N. B., Versari, L., Sohn, K., Minnen, D., et al. (2023).
Language Model Beats Diffusion — Tokenizer is Key to Visual Generation.
ICLR 2024. https://arxiv.org/abs/2310.05737 - Mentzer, F., Minnen, D., Agustsson, E., & Tschannen, M. (2023).
Finite Scalar Quantization: VQ-VAE Made Simple.
ICLR 2024. https://arxiv.org/abs/2309.15505 - van den Oord, A., Vinyals, O., & Kavukcuoglu, K. (2017).
Neural Discrete Representation Learning.
NeurIPS 2017. https://arxiv.org/abs/1711.00937 - Esser, P., Rombach, R., & Ommer, B. (2021).
Taming Transformers for High-Resolution Image Synthesis.
CVPR 2021. https://arxiv.org/abs/2012.09841 - Bengio, Y., Léonard, N., & Courville, A. (2013).
Estimating or Propagating Gradients Through Stochastic Neurons for Conditional Computation.
arXiv preprint. https://arxiv.org/abs/1308.3432 - Dosovitskiy, A., Beyer, L., Kolesnikov, A., Weissenborn, D., Zhai, X., Unterthiner, T., et al. (2021).
An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale.
ICLR 2021. https://arxiv.org/abs/2010.11929 - Heusel, M., Ramsauer, H., Unterthiner, T., Nessler, B., & Hochreiter, S. (2017).
GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium.
NeurIPS 2017. https://arxiv.org/abs/1706.08500 - Unterthiner, T., van Steenkiste, S., Kurach, K., Marinier, R., Michalski, M., & Gelly, S. (2018).
Towards Accurate Generative Models of Video: A New Metric & Challenges.
arXiv preprint. https://arxiv.org/abs/1812.01717 - Han, J., Liu, J., Jiang, Y., Yan, B., Zhang, Y., Yuan, Z., Peng, B., & Liu, X. (2024).
Infinity: Scaling Bitwise AutoRegressive Modeling for High-Resolution Image Synthesis.
arXiv preprint. https://arxiv.org/abs/2412.04431 - LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (1998).
Gradient-Based Learning Applied to Document Recognition.
Proceedings of the IEEE, 86(11), 2278–2324.
🏷️ 데이터·코드·그림 출처
본문 실험은 MNIST 손글씨 숫자 데이터셋(LeCun et al., 1998)을 사용하였습니다. 첨부한 bsq_demo.7z의 코드는 생성형 AI의 도움을 받아 초안을 작성한 뒤 필자가 검토·수정하고 직접 실행하여 결과를 검증한 것이며, 위젯은 필자가 직접 제작하였습니다. 그래프와 복원 이미지는 위 코드의 실행 결과이며, 참고문헌에 수록된 논문의 도표를 전재한 것은 없습니다.