반응형

전체 글 99

02. 왜 적응 신호 처리인가?: 고정 필터의 한계와 적응 필터의 4대 문제

지난 01편에서는 앞으로 다룰 전체 커리큘럼과 학습 로드맵을 그려 보았습니다. 이론으로 들어가기 전에 먼저 던져야 할 가장 근본적인 질문은 "왜 적응(Adaptive)해야 하는가?"입니다. 필터 설계는 DSP 수업에서 이미 배웠는데 적응 필터라는 분야가 왜 따로 필요한지, 이번 편에서는 이 질문에 실험으로 답해 두려고 합니다.신호 처리의 기초를 배우면서 우리는 다양한 필터를 설계해 보았습니다. 특정 주파수를 걸러내는 저역통과 필터(LPF)나 대역통과 필터(BPF)가 대표적입니다. 하지만 현실 세계의 신호는 실험실의 환경처럼 얌전하지 않습니다. 상황을 하나 가정하겠습니다. 인버터로 구동되는 모터가 달린 설비에 센서를 붙여 미세한 진동 신호를 측정하고 있습니다. 모터가 돌면 회전 주파수와 같은 주파수의 잡음..
선형 회귀(Linear Regression): 최소제곱법과 경사하강법

자취방을 구해 본 사람이라면 한 번쯤 해 봤을 계산이 있습니다. 방이 조금 넓어지면 월세가 얼마나 오르는지, 역에서 5분 더 걸어도 괜찮다면 얼마를 아낄 수 있는지 같은 계산입니다. 매물 몇 개를 비교해 감으로 답할 수도 있지만, 매물이 수백 개라면 데이터에서 그 숫자를 직접 뽑아내는 편이 낫습니다. 선형 회귀(Linear Regression)는 이 일을 하는 가장 단순한 도구입니다.단순하다고 가볍게 넘길 주제는 아닙니다. 손실함수를 정하고, 그 값을 가장 작게 만드는 파라미터를 찾고, 처음 보는 데이터로 성능을 확인하는 머신러닝의 기본 절차가 선형 회귀 안에 모두 들어 있습니다. 신경망의 뉴런 하나도 입력의 가중합에 활성화 함수를 씌운 것이어서, 활성화 함수를 떼어 내면 선형 회귀가 남습니다. 모델이 ..

색공간 변환기: RGB·XYZ·Lab·YCbCr·HSV 값을 공식과 함께 바로 계산

지금까지 이 블로그에서는 RGB, XYZ, Lab, YCbCr, HSV 다섯 가지 색공간을 차례로 다루었습니다. 글마다 수식과 Python 실습으로 각 색공간을 살펴보았지만, 막상 "이 주황색은 Lab으로 얼마일까", "YCbCr (81, 90, 240)은 무슨 색일까" 같은 궁금증이 생길 때마다 코드를 꺼내 실행하는 것은 번거로운 일입니다.그래서 값 하나를 바로 바꿔 볼 수 있는 색공간 변환기를 만들었습니다. 입력과 출력 색공간을 고르고 숫자를 넣으면 변환된 값이 나오고, 그 아래에 방금 쓰인 공식과 단계별 계산값이 함께 표시됩니다. 결과만 알려 주는 계산기가 아니라, 그 값이 어떤 식을 거쳐 나왔는지 따라가 볼 수 있게 하는 것이 목표였습니다.이 글에서는 변환기의 사용법과 계산 기준을 설명하고, 변환..

영상처리 2026.10.17

사전 학습 ViT는 어디를 보는가 — 어텐션 거리로 찾은 국소 헤드

직전 ViT 글에서는 CIFAR-10으로 직접 학습시킨 소형 ViT를 해부했습니다. 패치 임베딩과 위치 임베딩이 무엇을 배우는지 확인했고, 마지막 절에서는 학습이 끝난 모델이 이미지의 어느 범위를 보는지 평균 어텐션 거리와 엔트로피로 재 봤습니다. 그런데 한 가지가 원 논문과 어긋났습니다. 원 논문은 대규모로 사전 학습한 ViT의 낮은 층에 쿼리 주변만 보는 헤드와 이미지 대부분을 보는 헤드가 함께 있다고 보고했지만, 소형 모델의 헤드 18개는 모두 "모든 패치를 똑같이 볼 때"의 평균 거리 근처에 머물렀습니다. 헤드를 12개로 늘려 다시 학습해도 국소 헤드는 나타나지 않았습니다.그 실험으로 원인 후보 가운데 헤드 수는 지웠고, 패치 수와 입력 해상도, 학습 데이터 규모 세 가지가 남았습니다. 이번 글에..

ViT (Vision Transformer) — 이미지를 단어처럼 처리하는 딥러닝의 진화

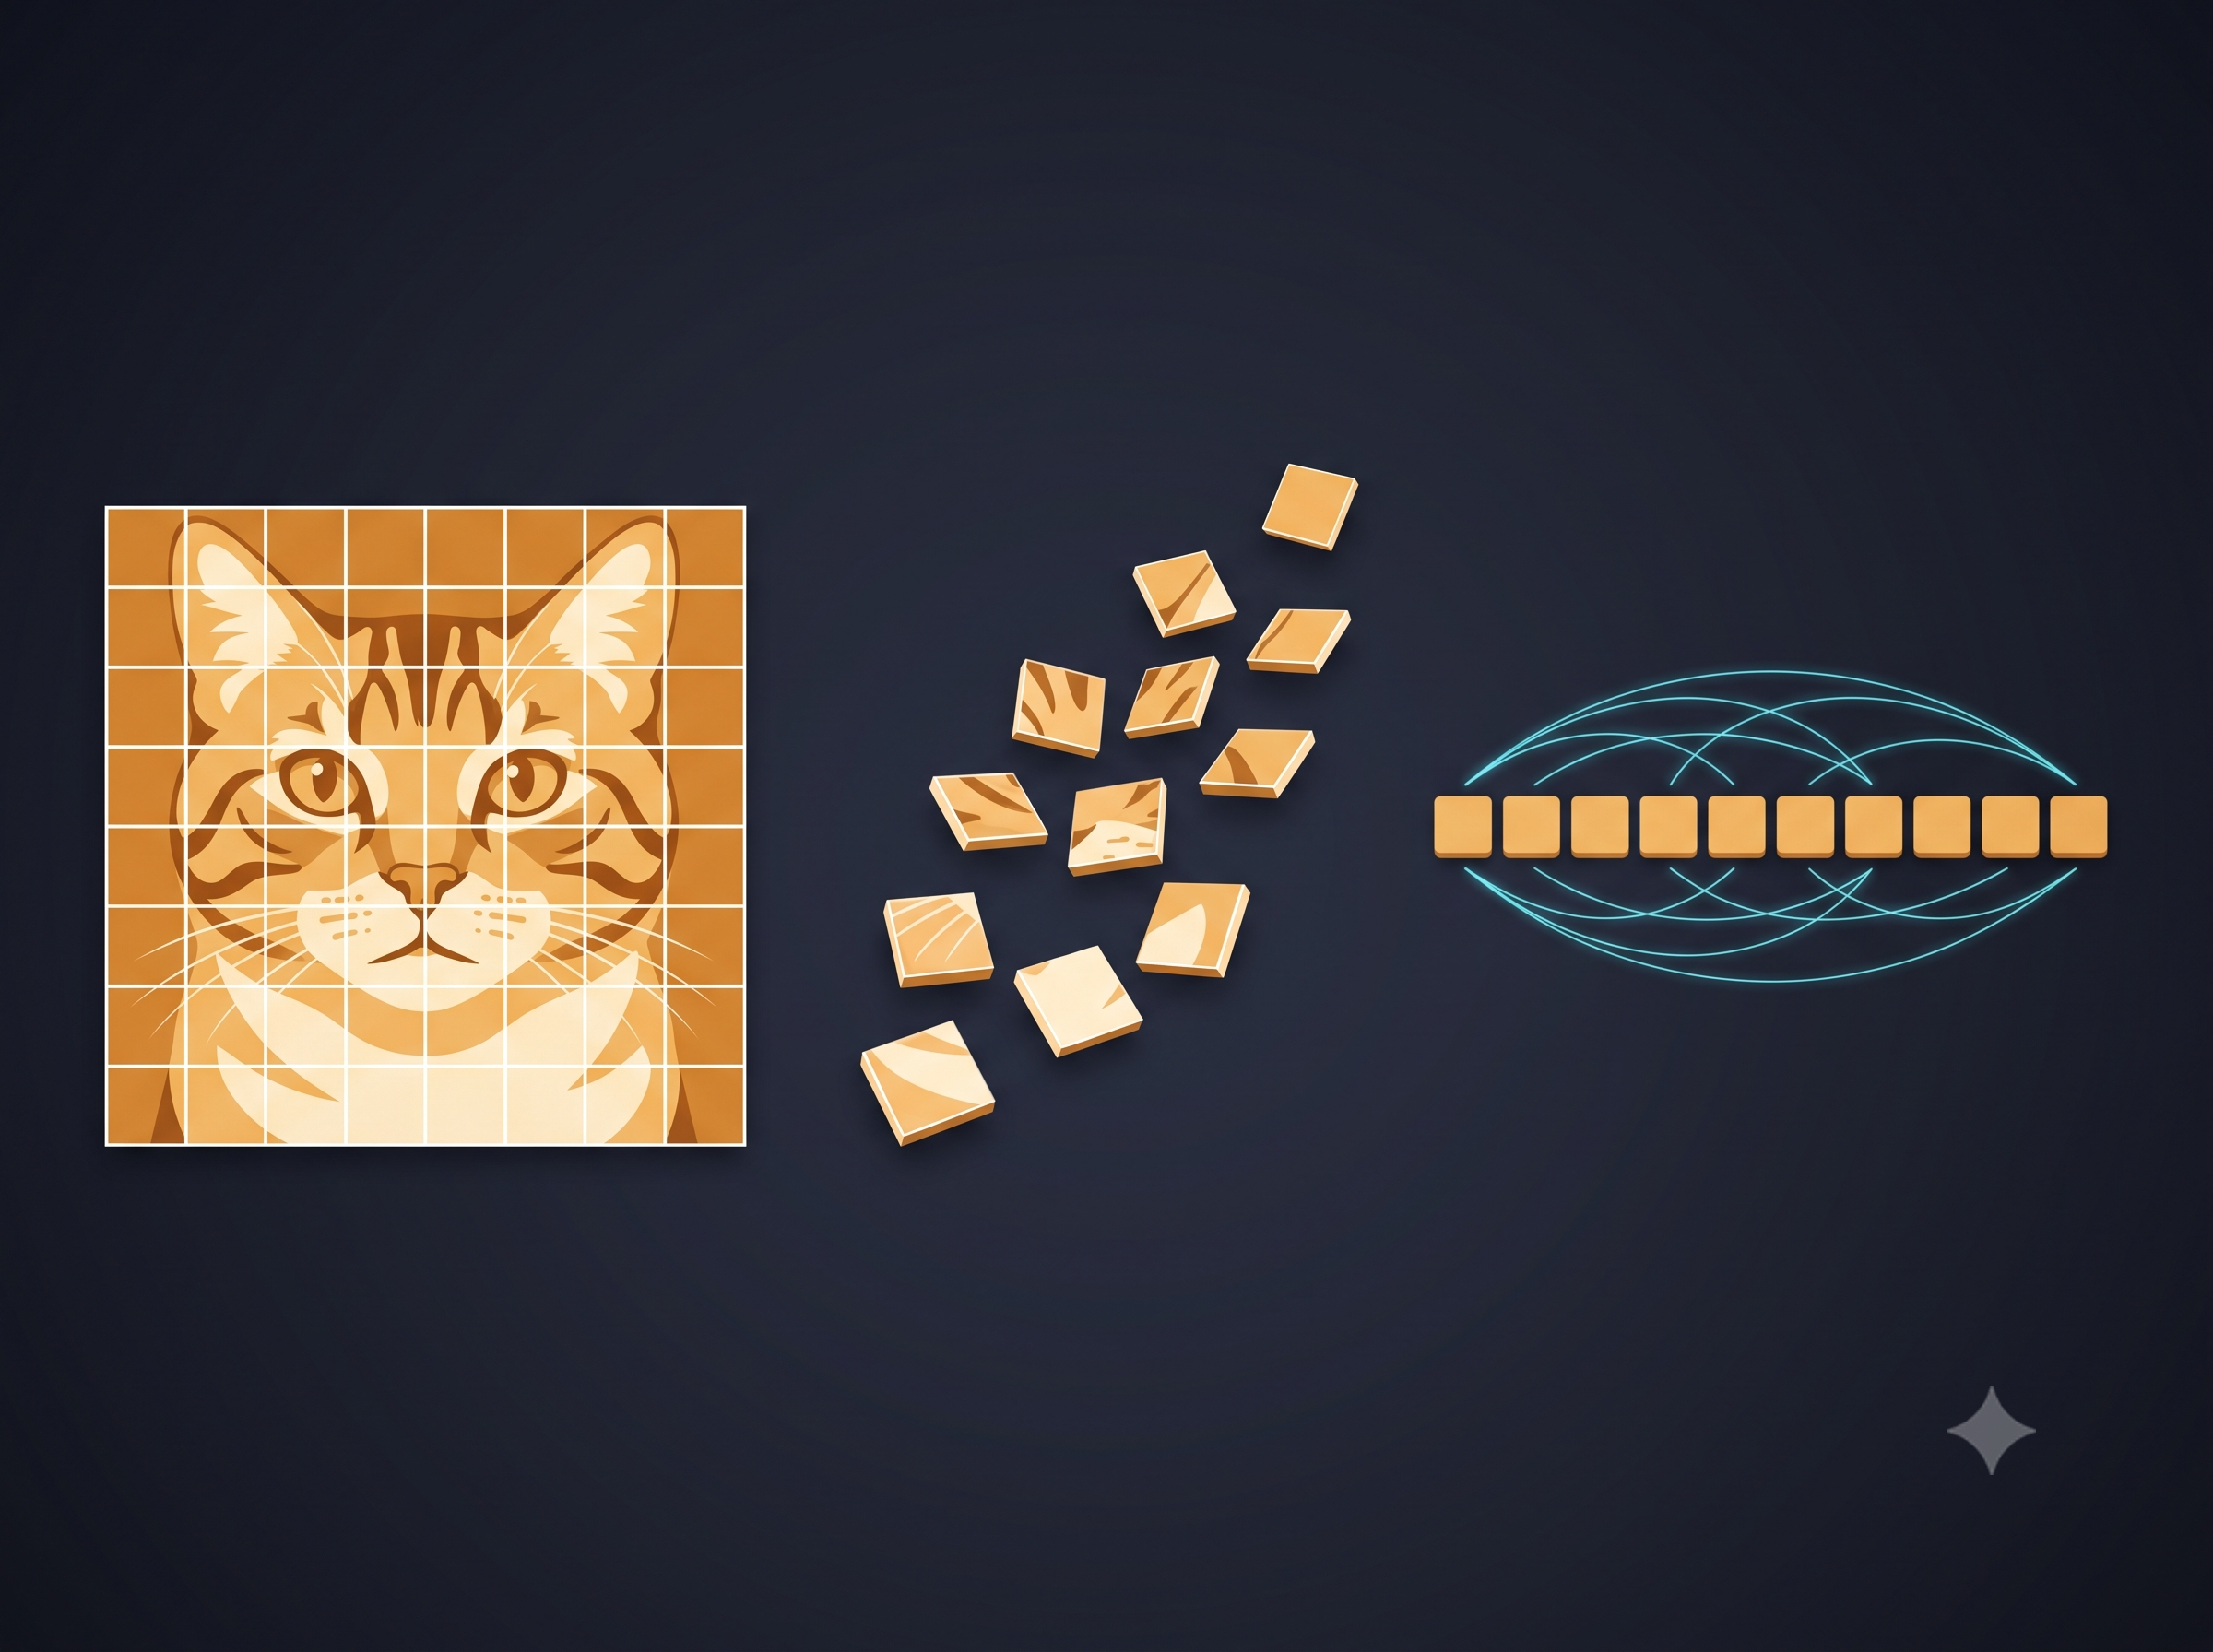
지난 시간까지 우리는 CNN을 비롯하여 RNN, Seq2Seq, Attention, 그리고 자연어 처리의 패러다임을 바꾼 Transformer까지 딥러닝의 핵심 아키텍처들을 단계별로 살펴보았습니다. 자연어 처리 분야에서 Transformer가 거둔 압도적인 성공은 많은 연구자들에게 한 가지 흥미로운 질문을 던졌습니다. 텍스트를 처리하는 이 강력한 구조를 컴퓨터 비전 분야에도 그대로 적용할 수 없을까 하는 의문이었습니다.CNN 편에서 다룬 합성곱은 이미지에 관한 몇 가지 가정을 연산 구조 자체에 새겨 넣은 도구입니다. 가까운 픽셀끼리 관계가 깊다는 가정, 그리고 같은 무늬는 이미지의 어느 위치에 있어도 같은 필터로 잡아낼 수 있다는 가정입니다. 이 가정들이 대체로 맞기 때문에 합성곱은 30년 가까이 이미지..

GPT와 BERT는 어디서 갈라졌을까 — Transformer 계보

앞 글에서 만든 모델을 다시 떠올려 보겠습니다. 6층짜리 블록을 쌓고, 어텐션에 causal 마스크를 걸고, 다음 문자를 맞히게 학습시켰습니다. 잘 돌아갔고, 생성한 문장도 문법 검사기를 통과했습니다.그런데 그 모델은 원 논문의 구조에서 꽤 많은 것을 떼어 낸 것입니다. 원 논문의 Transformer는 번역기였습니다. 원문을 읽는 인코더와 번역문을 쓰는 디코더가 짝을 이루고, 그 둘을 교차 어텐션이 이어 주는 구조였습니다. 앞 글의 모델에는 인코더가 없고 교차 어텐션도 없습니다. 절반만 남긴 셈인데도 문장이 만들어졌습니다.이상한 일이 아닙니다. 오늘날 이름이 알려진 모델들도 사정이 비슷합니다. GPT는 디코더 쪽만 남겼고, BERT는 인코더 쪽만 남겼고, T5는 둘 다 남겼습니다. 셋 다 같은 블록을 ..

01. Python으로 배우는 Adaptive Signal Processing - 전체 커리큘럼

안녕하세요. 새롭게 연재를 시작하는 「Python으로 배우는 Adaptive Signal Processing」 시리즈에 오신 것을 환영합니다. 본 시리즈에서는 변화하는 신호와 환경에 맞춰 스스로 계수를 고쳐 나가는 알고리즘, Adaptive Signal Processing(적응 신호 처리)을 Python으로 직접 구현하며 배워 보고자 합니다.왜 지금 Adaptive Signal Processing인가?대학의 DSP 수업에서 다루는 필터는 대부분 설계가 끝나는 순간 계수가 고정됩니다. 저역 통과 필터든 노치 필터든, 신호와 잡음의 특성을 미리 알고 있다는 전제 위에서 설계하기 때문입니다. 그런데 현실의 신호는 이 전제를 자주 깨뜨립니다. 화상회의 중 사람이 자리를 옮기면 스피커에서 마이크로 되돌아오는 에코..

📖 Python으로 배우는 Adaptive Signal Processing: 시리즈 전체 참고문헌

본 페이지는 [Python으로 배우는 Adaptive Signal Processing] 시리즈 전 편에서 참고한 문헌을 주제별로 정리한 것입니다. 시리즈 본문에서 직접 근거로 삼은 문헌만 수록하였으며, 개념 소개 수준으로 언급한 주제의 문헌은 제외하였습니다. 시리즈가 연재되는 동안 각 편이 발행될 때마다 해당 편의 문헌을 추가합니다.상당수 논문은 IEEE, Wiley 등 학술 데이터베이스를 통해 제공되며, 소속 기관의 구독 여부에 따라 접근 범위가 다를 수 있습니다. 무료로 공개된 자료에는 링크를 함께 표기하였습니다. 1. 교과서 및 종합 문헌Haykin, S. (2013).Adaptive Filter Theory (5th ed.). Pearson.Sayed, A. H. (2008).Adaptive Fi..

📖 참고문헌 2026.10.05

Transformer 학습 가이드: BPE와 워밍업부터 KV 캐시까지

Transformer 편에서는 Self-attention부터 인코더·디코더 블록까지 부품을 하나씩 뜯어봤습니다. 그런데 그 글에는 빠진 것이 하나 있습니다. 학습된 모델이 한 번도 등장하지 않았다는 점입니다. 어텐션 가중치를 손으로 계산해 보고, 스케일링을 빼면 분포가 어떻게 무너지는지 확인하고, 블록을 쌓았을 때 기울기가 어떻게 전달되는지까지 봤지만, 그 모든 실험의 가중치는 무작위였거나 초기화 직후 상태였습니다.부품을 다 만들었으니 이제 돌려 볼 차례입니다. 이 글에서는 실제로 동작하는 언어 모델 하나를 처음부터 끝까지 만들어 봅니다. 입력을 토큰으로 쪼개는 일에서 시작해, 학습이 무너지지 않게 붙잡아 주는 장치들을 살펴보고, 학습이 끝난 모델의 어텐션이 실제로 무엇을 보고 있는지 재 본 다음, 그 ..

패러다임을 바꾼 트랜스포머(Transformer): Self-Attention부터 인코더-디코더까지

지난 글에서 어텐션을 다루면서, 디코더가 매 시점 원문 전체를 훑어보고 필요한 곳에 가중치를 몰아주는 과정을 살펴보았습니다. 고정 길이 벡터 하나에 문장을 밀어 넣던 seq2seq의 병목이 사라졌고, 학습된 정렬 행렬도 눈으로 확인했습니다.그런데 그 구조에는 어색한 구석이 남아 있었습니다. 어텐션은 문장의 어느 위치든 한 번에 접근할 수 있는데, 정작 그 어텐션이 얹혀 있는 토대는 여전히 RNN이었습니다. RNN은 t번째 은닉 상태를 계산하려면 t-1번째를 먼저 알아야 합니다. 문장이 길어지면 그만큼 순서대로 기다려야 하고, GPU가 아무리 많은 연산을 동시에 처리할 수 있어도 이 사슬은 풀리지 않습니다. 어텐션이 성능을 끌어올릴수록 "그럼 밑에 깔린 순환은 왜 필요한가"라는 질문이 선명해졌습니다.201..

반응형