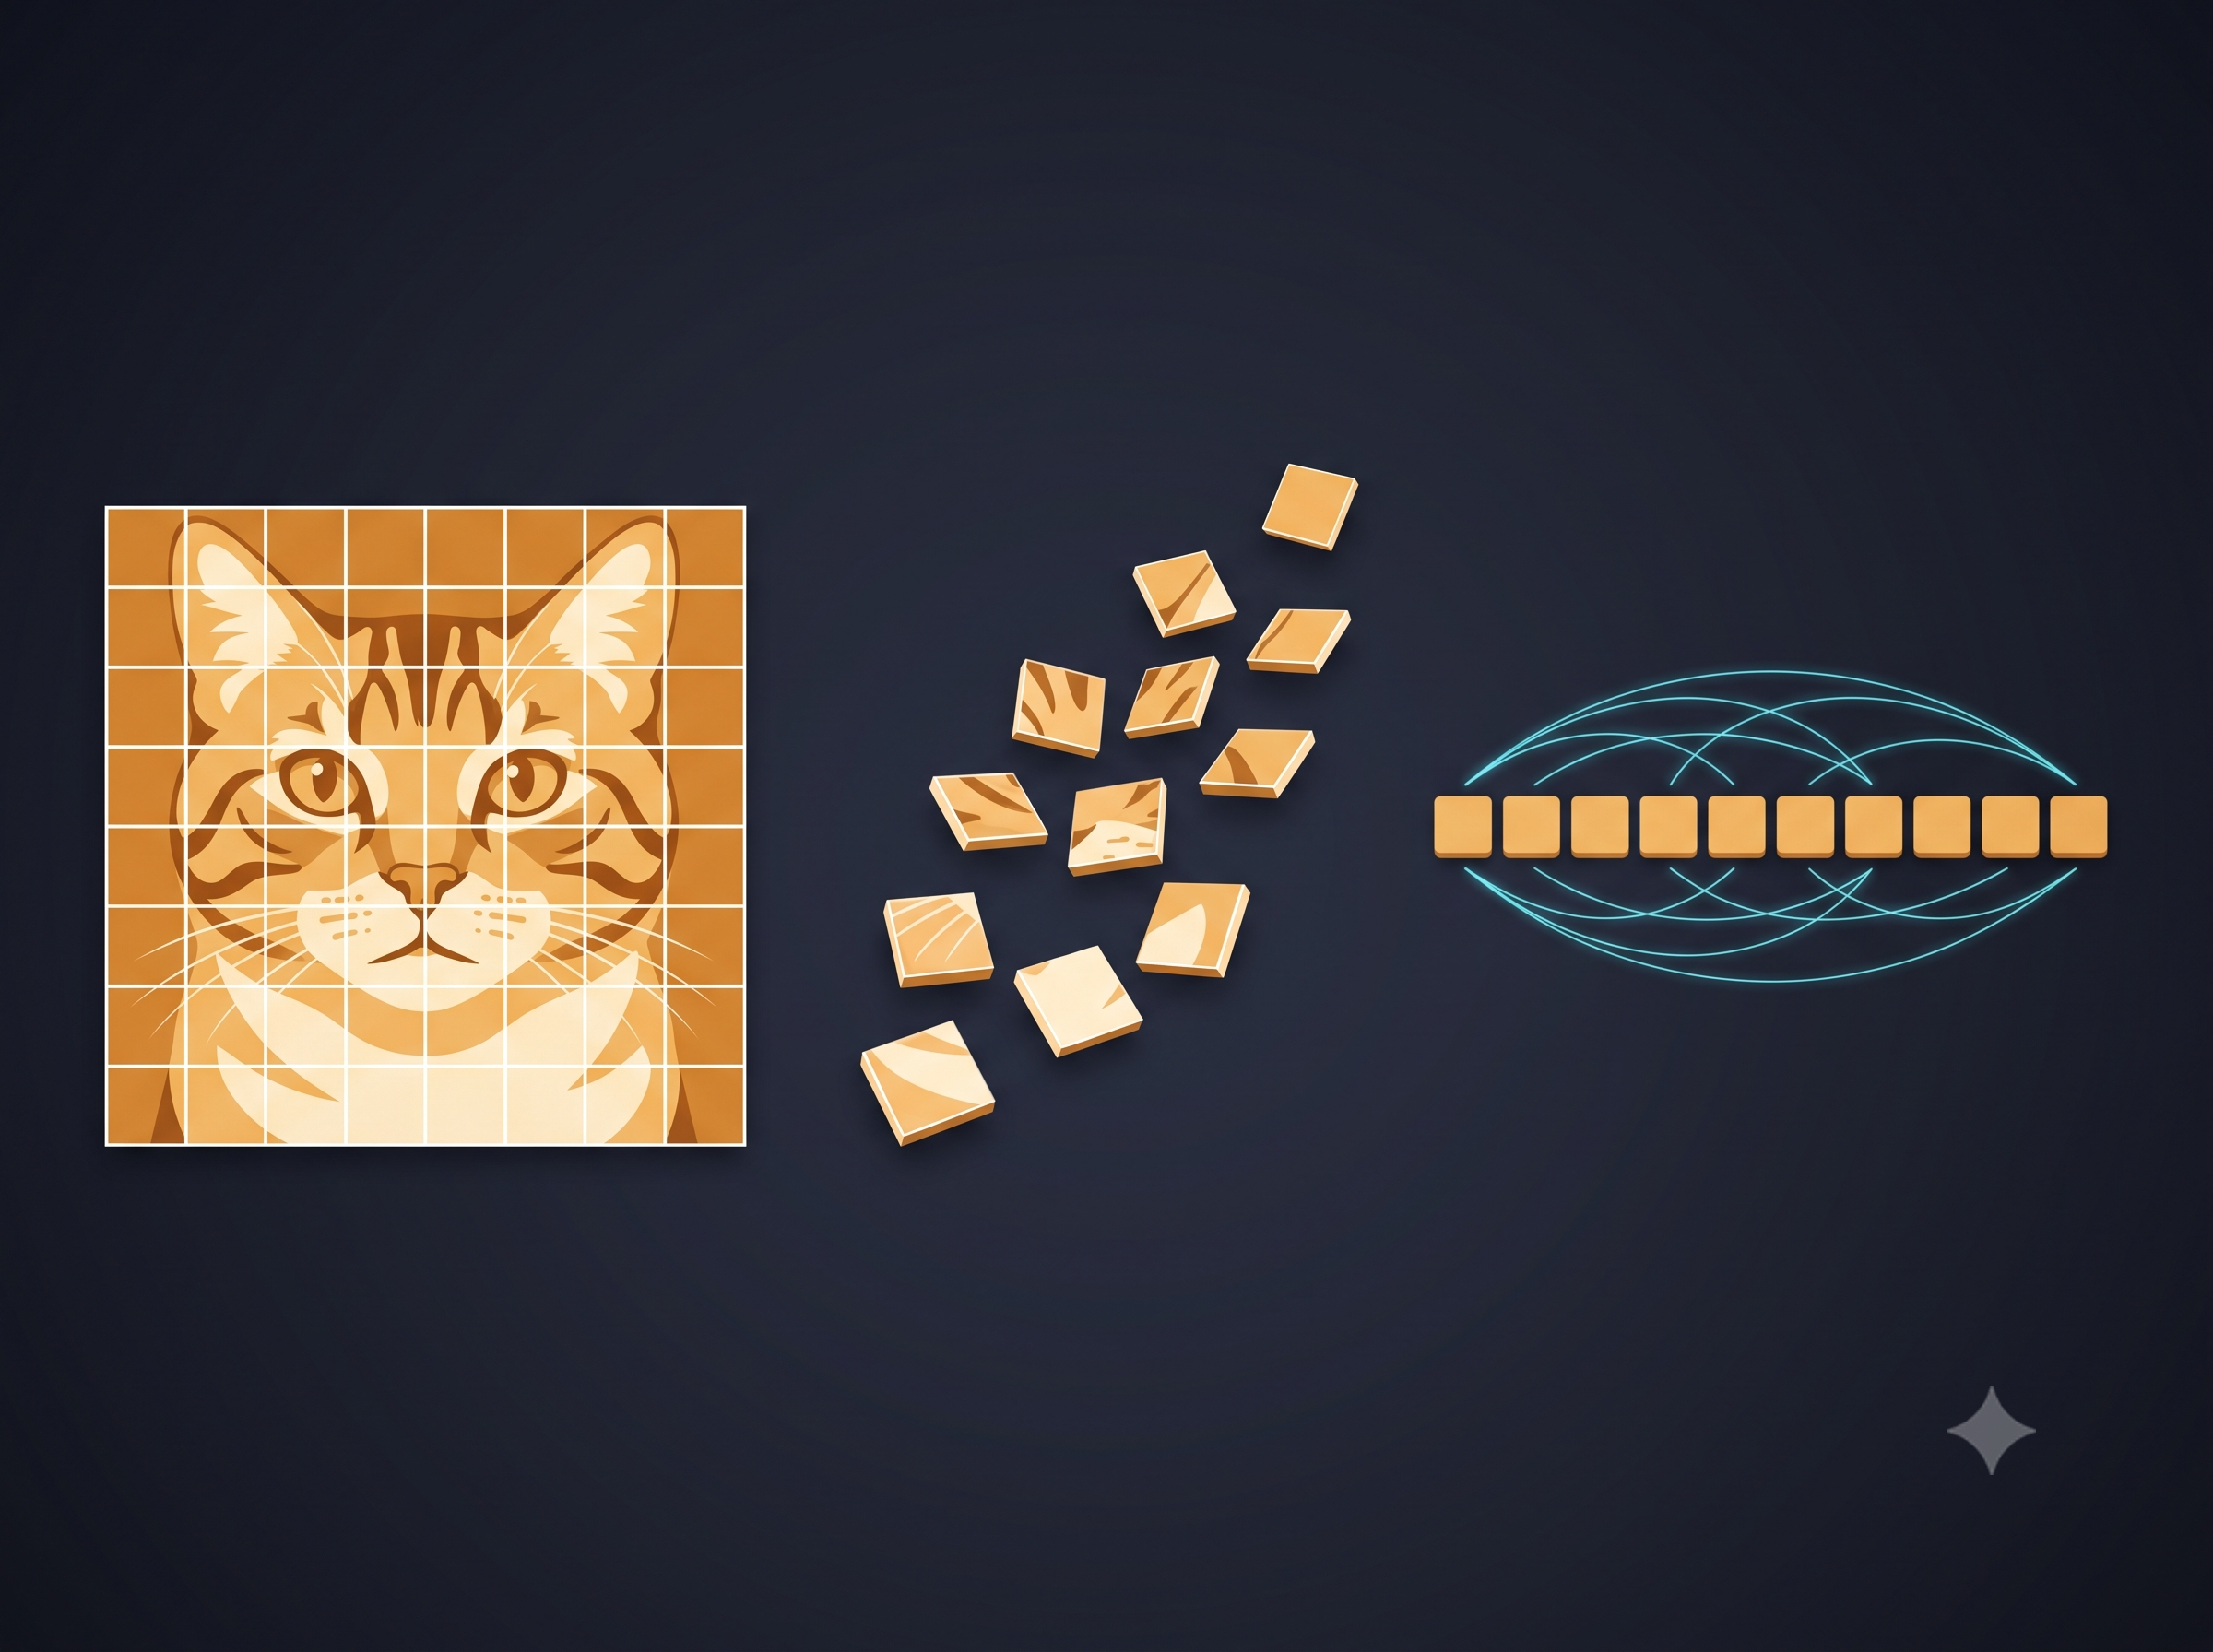
지난 시간까지 우리는 CNN을 비롯하여 RNN, Seq2Seq, Attention, 그리고 자연어 처리의 패러다임을 바꾼 Transformer까지 딥러닝의 핵심 아키텍처들을 단계별로 살펴보았습니다. 자연어 처리 분야에서 Transformer가 거둔 압도적인 성공은 많은 연구자들에게 한 가지 흥미로운 질문을 던졌습니다. 텍스트를 처리하는 이 강력한 구조를 컴퓨터 비전 분야에도 그대로 적용할 수 없을까 하는 의문이었습니다.CNN 편에서 다룬 합성곱은 이미지에 관한 몇 가지 가정을 연산 구조 자체에 새겨 넣은 도구입니다. 가까운 픽셀끼리 관계가 깊다는 가정, 그리고 같은 무늬는 이미지의 어느 위치에 있어도 같은 필터로 잡아낼 수 있다는 가정입니다. 이 가정들이 대체로 맞기 때문에 합성곱은 30년 가까이 이미지..