지난 글에서 어텐션을 다루면서, 디코더가 매 시점 원문 전체를 훑어보고 필요한 곳에 가중치를 몰아주는 과정을 살펴보았습니다. 고정 길이 벡터 하나에 문장을 밀어 넣던 seq2seq의 병목이 사라졌고, 학습된 정렬 행렬도 눈으로 확인했습니다.
그런데 그 구조에는 어색한 구석이 남아 있었습니다. 어텐션은 문장의 어느 위치든 한 번에 접근할 수 있는데, 정작 그 어텐션이 얹혀 있는 토대는 여전히 RNN이었습니다. RNN은 t번째 은닉 상태를 계산하려면 t-1번째를 먼저 알아야 합니다. 문장이 길어지면 그만큼 순서대로 기다려야 하고, GPU가 아무리 많은 연산을 동시에 처리할 수 있어도 이 사슬은 풀리지 않습니다. 어텐션이 성능을 끌어올릴수록 "그럼 밑에 깔린 순환은 왜 필요한가"라는 질문이 선명해졌습니다.
2017년의 대답은 단호했습니다. 필요 없다는 것이었습니다. 순환도 합성곱도 걷어내고 어텐션만 남긴 구조가 번역 성능에서 기존 모델을 앞질렀고, 학습 시간은 오히려 크게 줄었습니다. 이 구조가 Transformer이며, 오늘날 언어 모델과 이미지 모델 대부분의 뼈대입니다.
이 글에서는 Transformer를 부품 단위로 뜯어봅니다. 순환 없이 어떻게 문맥을 섞는지, 왜 하필 $\sqrt{d_k}$로 나누는지, 순서 정보는 어디서 들어오는지, 그리고 이 구조가 무엇을 대가로 치르는지 순서대로 확인하겠습니다.
1. 순환을 버리면 무엇이 남는가
지난 글의 어텐션은 두 시퀀스 사이의 다리였습니다. 디코더의 현재 상태가 쿼리가 되고, 인코더가 읽은 원문이 키와 값이 되어, 번역할 단어마다 원문의 어느 부분을 볼지 결정했습니다.
여기서 발상을 하나 바꿔 봅니다. 두 시퀀스가 아니라 하나의 문장 안에서 같은 일을 하면 어떻게 될까요. 문장의 각 단어가 스스로 쿼리가 되어 같은 문장의 다른 단어들을 둘러보는 것입니다. "그 은행에 갔다"에서 "은행"이 주변의 "갔다"를 확인하고 금융기관 쪽으로 의미를 좁히는 식입니다. 쿼리와 키와 값이 모두 같은 곳에서 나온다는 뜻으로 이를 Self-attention이라고 부릅니다.
계산은 지난 글과 같습니다. 입력 $X$의 각 행이 토큰 하나이고, 여기에 세 개의 가중치 행렬을 곱해 역할을 나눕니다.
$Q$는 "내가 무엇을 찾는가", $K$는 "나는 무엇을 가졌는가", $V$는 "내가 실제로 전달할 내용"입니다. $QK^\text{T}$는 모든 토큰 쌍의 궁합 점수를 담은 $n \times n$ 행렬이고, softmax를 거치면 각 행의 합이 1인 어텐션 가중치가 됩니다. 마지막으로 이 가중치로 $V$의 행들을 평균 내면 출력이 나옵니다.
주목할 부분은 이 식 어디에도 시점이 없다는 점입니다. 모든 토큰 쌍의 점수가 행렬 곱 한 번에 동시에 계산되므로, 문장이 100단어든 1000단어든 GPU에서 한 번에 처리됩니다. RNN이 100번 순서대로 밟아야 했던 길을 한 걸음으로 끝내는 셈입니다.
아래 코드는 토큰 4개, d_model = d_k = 4인 최소 예제입니다. 가중치는 설명을 위해 임의로 고른 정수이며, 실제로는 학습으로 얻습니다.
import torch

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.shape[-1]
    scores = Q @ K.transpose(-2, -1) / (d_k ** 0.5)
    if mask is not None:
        scores = scores.masked_fill(mask, float('-inf'))
    attn = torch.softmax(scores, dim=-1)
    return attn @ V, attn

X   = torch.tensor([[0., 0., 1., 0.], [1., 1., 1., 0.],
                    [1., 1., 0., 1.], [0., 0., 0., 1.]])
W_Q = torch.tensor([[0., -1., -1., -1.], [-1., 1., 1., -1.],
                    [0., -1., 1., 1.], [0., -1., -1., 0.]])
W_K = torch.tensor([[0., -1., 0., 1.], [1., -1., 0., 1.],
                    [1., 1., -1., -1.], [0., 1., 1., 0.]])
W_V = torch.tensor([[1., 0., 2., 0.], [0., 2., 0., 1.],
                    [2., 1., 0., 0.], [0., 0., 1., 2.]])

Q, K, V = X @ W_Q, X @ W_K, X @ W_V
out, attn = scaled_dot_product_attention(Q, K, V)
print("어텐션 가중치:\n", attn)
print("출력:\n", out)
어텐션 가중치:
tensor([[0.0217, 0.1607, 0.7201, 0.0975],
[0.1674, 0.1015, 0.2760, 0.4551],
[0.6684, 0.1491, 0.0333, 0.1491],
[0.1966, 0.5344, 0.1966, 0.0723]])
출력:
tensor([[1.2456, 1.9440, 2.5792, 2.5159],
[0.9154, 1.0240, 1.4861, 1.8397],
[1.8176, 1.1824, 0.5473, 0.5473],
[2.1932, 2.1932, 1.7311, 1.2689]])첫 번째 행을 읽어 보면, 1번 토큰은 자기 자신에게 0.0217만 쓰고 3번 토큰에 0.7201을 몰아주었습니다. 출력의 첫 행은 결국 $0.0217 \times V_1 + 0.1607 \times V_2 + 0.7201 \times V_3 + 0.0975 \times V_4$입니다. 순환도 합성곱도 없이, 가중 평균 한 번으로 문장 전체의 정보가 섞였습니다.
2. $\sqrt{d_k}$는 왜 나누는가
식에 등장한 $\sqrt{d_k}$는 얼핏 임의의 상수처럼 보입니다. 그런데 이 나눗셈을 빼면 모델이 학습을 거의 하지 못합니다.
이유는 내적의 크기에 있습니다. $q$와 $k$의 각 성분이 평균 0, 분산 1로 서로 독립이라면, 내적은 그런 항 $d_k$개의 합이므로 분산이 $d_k$가 됩니다. 즉 표준편차가 $\sqrt{d_k}$에 비례해 커집니다. $d_k = 64$라면 점수들이 대략 $\pm 8$ 범위에 흩어지고, $d_k = 1024$라면 $\pm 32$까지 벌어집니다.
softmax 입장에서 이 차이는 치명적입니다. 입력 간격이 벌어질수록 출력은 한 곳으로 몰리고, 결국 특정 위치의 확률이 1에 가까워집니다. 문제는 그 지점에서 기울기가 함께 사라진다는 것입니다. softmax의 야코비 행렬은 $\text{diag}(p) - pp^\text{T}$이므로, $p$가 한 곳에 몰리면 성분이 모두 0에 수렴합니다. 학습 초기에 이런 상태가 되면 모델은 "어디를 봐야 하는지"를 배울 기회조차 잃습니다.
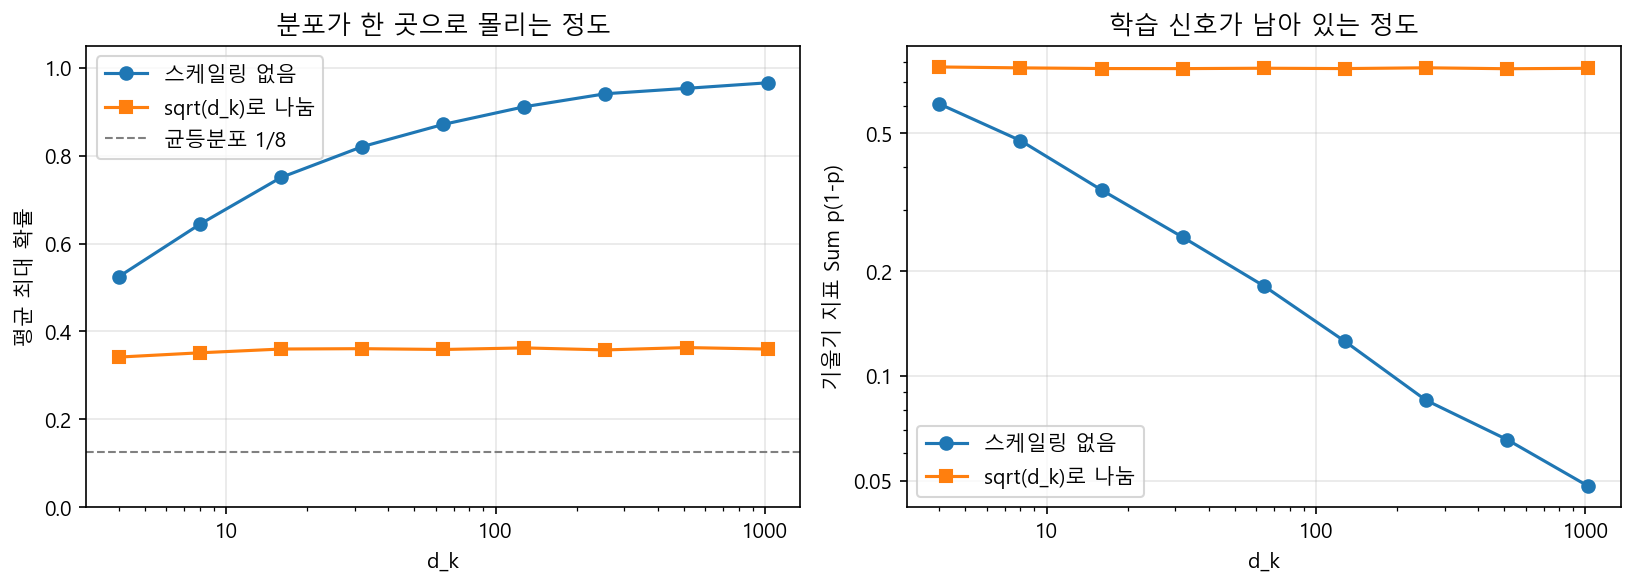
말로만 하면 와닿지 않으니 직접 재 보겠습니다. 키 8개에 대해 차원만 바꿔 가며 분포와 기울기를 측정합니다.
import numpy as np

def softmax_np(z):
    z = z - z.max()
    e = np.exp(z)
    return e / e.sum()

rng = np.random.default_rng(20260830)
n_keys, trials = 8, 20000

for d in [4, 16, 64, 256, 1024]:
    std, pr, ps, jr, js = [], [], [], [], []
    for _ in range(trials):
        q = rng.standard_normal(d)
        K = rng.standard_normal((n_keys, d))
        z = K @ q
        std.append(z.std())
        p1, p2 = softmax_np(z), softmax_np(z / np.sqrt(d))
        pr.append(p1.max()); ps.append(p2.max())
        jr.append((p1 * (1 - p1)).sum())
        js.append((p2 * (1 - p2)).sum())
    print(f"d_k={d:5d}  로짓 표준편차 {np.mean(std):6.2f} | "
          f"최대확률 {np.mean(pr):.3f} → {np.mean(ps):.3f} | "
          f"기울기 지표 {np.mean(jr):.4f} → {np.mean(js):.4f}")
d_k= 4 로짓 표준편차 1.70 | 최대확률 0.529 → 0.345 | 기울기 지표 0.6014 → 0.7727
d_k= 16 로짓 표준편차 3.55 | 최대확률 0.748 → 0.357 | 기울기 지표 0.3480 → 0.7688
d_k= 64 로짓 표준편차 7.20 | 최대확률 0.875 → 0.361 | 기울기 지표 0.1766 → 0.7674
d_k= 256 로짓 표준편차 14.41 | 최대확률 0.937 → 0.360 | 기울기 지표 0.0891 → 0.7683
d_k= 1024 로짓 표준편차 28.93 | 최대확률 0.970 → 0.364 | 기울기 지표 0.0433 → 0.7657여기서 기울기 지표는 야코비 행렬의 대각합에 해당하는 $\sum p(1-p)$이며, 확률이 한 곳에 몰릴수록 0에 가까워집니다. 화살표 왼쪽이 스케일링을 하지 않은 경우, 오른쪽이 $\sqrt{d_k}$로 나눈 경우입니다.
스케일링이 없으면 $d_k$가 1024일 때 평균 최대 확률이 0.970까지 올라가고 기울기 지표는 0.043으로 주저앉습니다. 반면 $\sqrt{d_k}$로 나눈 쪽은 차원이 256배 달라져도 최대 확률 0.36, 기울기 지표 0.77 부근을 그대로 유지합니다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.ticker import LogLocator, FuncFormatter

# matplotlib 한글 폰트 설정
plt.rcParams['font.family'] = 'Malgun Gothic'
plt.rcParams['axes.unicode_minus'] = False

def use_plain_log_labels(ax, axis='x', subs=(1.0,)):
    t = ax.xaxis if axis == 'x' else ax.yaxis
    t.set_major_locator(LogLocator(base=10.0, subs=subs))
    t.set_major_formatter(FuncFormatter(lambda v, p: f'{v:g}'))
    t.set_minor_formatter(FuncFormatter(lambda v, p: ''))

def softmax_np(z):
    z = z - z.max()
    e = np.exp(z)
    return e / e.sum()

rng = np.random.default_rng(20260830)
dks = [4, 8, 16, 32, 64, 128, 256, 512, 1024]
n_keys, trials = 8, 4000
pmax_r, pmax_s, jac_r, jac_s = [], [], [], []
for d in dks:
    a, b, c, e = [], [], [], []
    for _ in range(trials):
        q = rng.standard_normal(d)
        K = rng.standard_normal((n_keys, d))
        z = K @ q
        p1, p2 = softmax_np(z), softmax_np(z / np.sqrt(d))
        a.append(p1.max()); b.append(p2.max())
        c.append((p1 * (1 - p1)).sum()); e.append((p2 * (1 - p2)).sum())
    pmax_r.append(np.mean(a)); pmax_s.append(np.mean(b))
    jac_r.append(np.mean(c)); jac_s.append(np.mean(e))

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].plot(dks, pmax_r, 'o-', label='스케일링 없음')
axes[0].plot(dks, pmax_s, 's-', label='sqrt(d_k)로 나눔')
axes[0].axhline(1 / n_keys, ls='--', c='gray', lw=1, label='균등분포 1/8')
axes[0].set_ylabel('평균 최대 확률'); axes[0].set_ylim(0, 1.05)
axes[1].plot(dks, jac_r, 'o-', label='스케일링 없음')
axes[1].plot(dks, jac_s, 's-', label='sqrt(d_k)로 나눔')
axes[1].set_ylabel('기울기 지표 Sum p(1-p)')
axes[1].set_yscale('log')
use_plain_log_labels(axes[1], 'y', subs=(1.0, 2.0, 5.0))
axes[0].set_title('분포가 한 곳으로 몰리는 정도')
axes[1].set_title('학습 신호가 남아 있는 정도')
for ax in axes:
    ax.set_xscale('log'); use_plain_log_labels(ax, 'x')
    ax.set_xlabel('d_k'); ax.grid(alpha=.3); ax.legend()
plt.tight_layout()
plt.savefig('transformer_scaling.png', dpi=150, bbox_inches='tight')
오른쪽 그래프를 로그축으로 그리면 파란 곡선이 거의 직선으로 내려갑니다. 기울기 지표가 $\sqrt{d_k}$에 반비례한다는 뜻입니다.
원 논문이 $d_k = 64$를 택한 것도 이 맥락에서 읽힙니다. 헤드를 8개로 쪼개 각 헤드의 차원을 낮게 유지하면, 스케일링과 함께 분포가 지나치게 뾰족해지는 것을 이중으로 막을 수 있습니다.
3. 멀티헤드: 같은 예산을 여러 관점으로 쪼개기
Self-attention 한 번은 토큰마다 확률 분포 하나를 만듭니다. 그런데 언어에서 한 단어가 맺는 관계는 한 종류가 아닙니다. "은행 앞에서 만난 친구가 웃었다"에서 "친구"는 문법적으로 "웃었다"의 주어이고, 의미적으로는 "만난"과 이어지며, 위치상으로는 바로 앞 단어와 붙어 있습니다. 분포 하나로 이 셋을 동시에 표현하려면 확률을 쪼개 나눠 써야 하고, 결국 어느 관계도 선명하게 잡지 못합니다.
해법은 단순합니다. 어텐션을 여러 벌 돌리고 결과를 합치는 것입니다. 다만 그냥 여러 벌 돌리면 계산량이 배로 늘어나므로, $d_{\text{model}}$을 $h$조각으로 나눠 각 헤드가 $d_{\text{model}}/h$ 차원만 담당하게 합니다.
$$\text{MultiHead}(X) = \text{Concat}(\text{head}_1, \dots, \text{head}_h) W_O$$
$$\text{head}_i = \text{Attention}(XW_Q^{(i)}, XW_K^{(i)}, XW_V^{(i)})$$
각 헤드가 독립적으로 어텐션을 계산하고, 결과를 이어 붙입니다. 원 논문의 기본 설정은 $d_{\text{model}} = 512, h = 8$이므로 헤드마다 64차원을 맡고, 이어 붙이면 다시 512차원이 됩니다.
마지막에 곱하는 $W_O$는 $d_{\text{model}} \times d_{\text{model}}$ 크기의 선형층입니다. 이것이 없으면 출력 벡터의 앞 64차원은 1번 헤드의 결과, 그다음 64차원은 2번 헤드의 결과가 되어, 헤드들이 각자 정해진 자리를 차지한 채 서로 만나지 않습니다. $W_O$는 이렇게 나란히 놓인 결과들을 한 번 섞어, 다음 층이 특정 헤드가 어느 구간에 있는지 알 필요 없이 통합된 벡터로 받게 해 줍니다. 헤드를 나눈 것이 분업이라면 $W_O$는 그 결과를 합치는 회의에 해당합니다.
실제 구현에서는 $Q, K, V$를 하나의 선형층으로 한꺼번에 계산한 뒤 reshape으로 헤드를 나눕니다. 아래 코드는 텐서 모양이 어떻게 바뀌는지 확인할 수 있도록 중간중간 출력을 넣었습니다.
import torch
import torch.nn as nn

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.shape[-1]
    scores = Q @ K.transpose(-2, -1) / (d_k ** 0.5)
    if mask is not None:
        scores = scores.masked_fill(mask, float('-inf'))
    attn = torch.softmax(scores, dim=-1)
    return attn @ V, attn

class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        self.h = n_heads
        self.d_head = d_model // n_heads
        self.qkv = nn.Linear(d_model, 3 * d_model, bias=False)
        self.proj = nn.Linear(d_model, d_model, bias=False)

    def forward(self, x, mask=None):
        B, N, D = x.shape
        qkv = self.qkv(x).reshape(B, N, 3, self.h, self.d_head)
        qkv = qkv.permute(2, 0, 3, 1, 4)
        q, k, v = qkv[0], qkv[1], qkv[2]
        print("  헤드 분할 후 q:", tuple(q.shape))
        o, a = scaled_dot_product_attention(q, k, v, mask)
        print("  어텐션 행렬 :", tuple(a.shape))
        o = o.transpose(1, 2).reshape(B, N, D)
        print("  concat 결과 :", tuple(o.shape))
        return self.proj(o)

mha = MultiHeadAttention(d_model=512, n_heads=8)
x = torch.randn(2, 10, 512)
print("입력       :", tuple(x.shape))
y = mha(x)
print("최종 출력  :", tuple(y.shape))
print("파라미터 수:", sum(p.numel() for p in mha.parameters()))
입력 : (2, 10, 512)
헤드 분할 후 q: (2, 8, 10, 64)
어텐션 행렬 : (2, 8, 10, 10)
concat 결과 : (2, 10, 512)
최종 출력 : (2, 10, 512)
파라미터 수: 1048576어텐션 행렬이 $(2, 8, 10, 10)$인 데 주목하십시오. 헤드마다 $10 \times 10$ 행렬이 하나씩, 총 8개가 만들어집니다.
더 눈여겨볼 것은 파라미터 수입니다. 1,048,576은 $4 \times 512^2$입니다. $W_Q$, $W_K$, $W_V$, $W_O$ 네 개뿐이고, 헤드 수를 1로 하든 16으로 하든 이 값은 변하지 않습니다. 멀티헤드는 모델을 키우는 장치가 아니라 같은 용량을 여러 관점으로 나눠 쓰는 장치입니다.
한 가지 덧붙이면, 헤드가 언제나 사람이 이해할 만한 역할을 깔끔하게 나눠 갖는 것은 아닙니다. 일부 헤드는 문법적 의존 관계나 드문 단어에 뚜렷하게 반응하지만, 상당수 헤드는 제거해도 성능이 크게 떨어지지 않는다는 보고도 있습니다 [11][12]. 헤드별 어텐션 그림을 해석할 때는 이 점을 염두에 두는 편이 안전합니다.
4. 순서를 어떻게 알려줄 것인가
여기서 심각한 문제가 하나 있습니다. 1절의 식을 다시 보면, 토큰의 순서를 알려 주는 항이 어디에도 없습니다. RNN은 순서대로 읽는다는 사실 자체에서 순서 정보를 공짜로 얻었지만, Self-attention은 모든 쌍을 대칭적으로 처리합니다.
그 결과가 어느 정도인지 확인해 보겠습니다. 입력 토큰의 순서를 섞은 뒤 계산한 결과와, 원래 순서로 계산한 뒤 같은 방식으로 섞은 결과를 비교합니다.
import numpy as np, torch

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.shape[-1]
    scores = Q @ K.transpose(-2, -1) / (d_k ** 0.5)
    if mask is not None:
        scores = scores.masked_fill(mask, float('-inf'))
    attn = torch.softmax(scores, dim=-1)
    return attn @ V, attn

g = np.random.default_rng(7)
n, d = 6, 16
X  = torch.tensor(g.standard_normal((n, d)), dtype=torch.float32)
Wq = torch.tensor(g.standard_normal((d, d)) / np.sqrt(d), dtype=torch.float32)
Wk = torch.tensor(g.standard_normal((d, d)) / np.sqrt(d), dtype=torch.float32)
Wv = torch.tensor(g.standard_normal((d, d)) / np.sqrt(d), dtype=torch.float32)

def attn_only(x):
    o, _ = scaled_dot_product_attention(x @ Wq, x @ Wk, x @ Wv)
    return o

def positional_encoding(n, d):
    pos = torch.arange(n).unsqueeze(1).float()
    i = torch.arange(d).unsqueeze(0).float()
    angle = pos / torch.pow(10000.0, (2 * (i // 2)) / d)
    pe = torch.zeros(n, d)
    pe[:, 0::2] = torch.sin(angle[:, 0::2])
    pe[:, 1::2] = torch.cos(angle[:, 1::2])
    return pe

perm = torch.tensor([3, 0, 5, 1, 4, 2])
print("계산 후 섞기 vs 섞은 후 계산, 최대 차이:",
      (attn_only(X)[perm] - attn_only(X[perm])).abs().max().item())

PE = positional_encoding(n, d)
print("위치 인코딩을 더한 뒤 같은 실험, 최대 차이:",
      (attn_only(X + PE)[perm] - attn_only(X[perm] + PE)).abs().max().item())
계산 후 섞기 vs 섞은 후 계산, 최대 차이: 1.1920928955078125e-07
위치 인코딩을 더한 뒤 같은 실험, 최대 차이: 0.557053804397583첫 번째 값은 부동소수점 오차 수준입니다. Self-attention에게 문장은 단어들의 순서 없는 집합일 뿐이며, "고양이가 쥐를 쫓았다"와 "쥐가 고양이를 쫓았다"를 구분하지 못한다는 뜻입니다. 두 번째 줄에서 차이가 0.557로 벌어진 것이 해법을 보여 줍니다. 각 위치마다 고유한 벡터를 만들어 입력에 더해 주면, 토큰 벡터 자체가 자기 자리를 기억하게 됩니다.
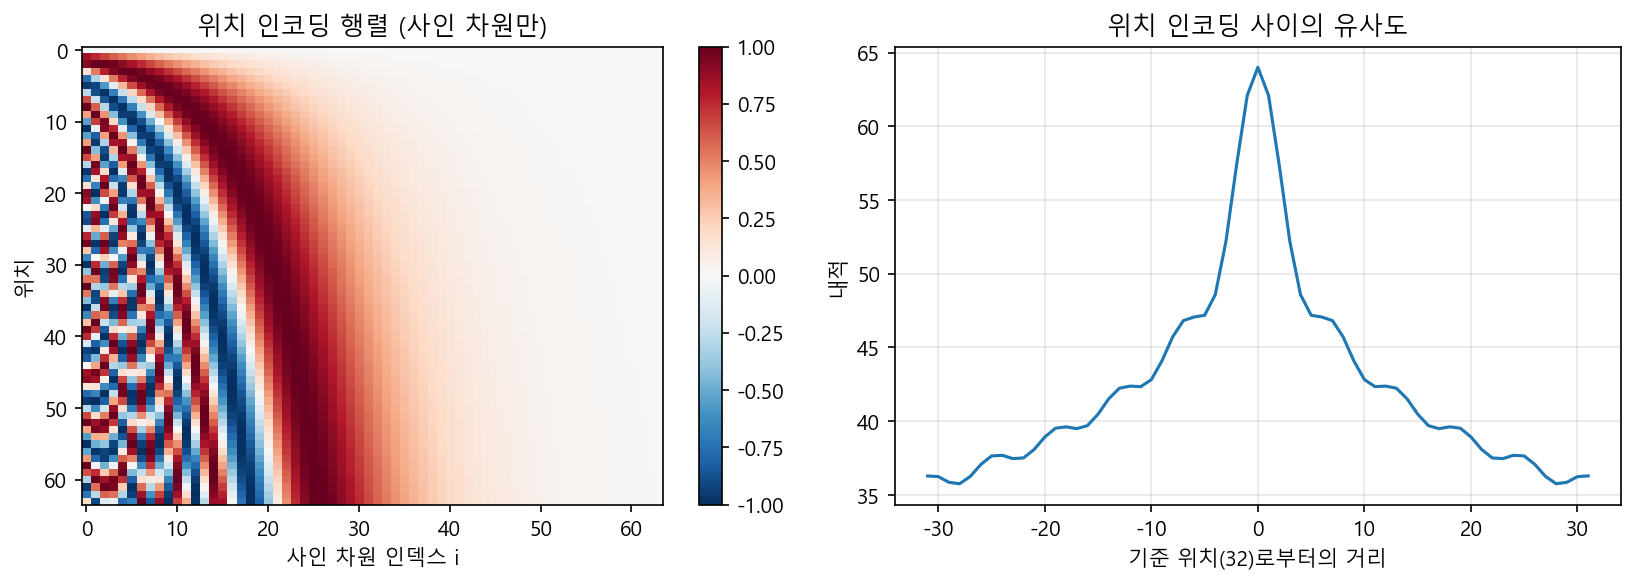
원 논문이 쓴 위치 인코딩은 주기가 다른 사인과 코사인을 층층이 쌓은 것입니다.
$$PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right), \quad PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right)$$
차원 인덱스 $i$가 커질수록 파장이 길어집니다. 앞쪽 차원은 짧은 주기로 진동해 바로 옆 위치도 구분하고, 뒤쪽 차원은 아주 느리게 변해 문장 전체 규모의 위치를 담습니다. 자릿수가 다른 시계바늘을 여러 개 겹쳐 놓은 것과 같습니다. 초침만 보면 한 바퀴 뒤와 구분이 안 되지만, 시침과 분침을 함께 보면 하루 중 어느 시각인지 정해집니다.
import numpy as np
import torch
import matplotlib.pyplot as plt

# matplotlib 한글 폰트 설정
plt.rcParams['font.family'] = 'Malgun Gothic'
plt.rcParams['axes.unicode_minus'] = False

def positional_encoding(n, d):
    pos = torch.arange(n).unsqueeze(1).float()
    i = torch.arange(d).unsqueeze(0).float()
    angle = pos / torch.pow(10000.0, (2 * (i // 2)) / d)
    pe = torch.zeros(n, d)
    pe[:, 0::2] = torch.sin(angle[:, 0::2])
    pe[:, 1::2] = torch.cos(angle[:, 1::2])
    return pe

PE = positional_encoding(64, 128).numpy()

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
im = axes[0].imshow(PE[:, 0::2], aspect='auto', cmap='RdBu_r', vmin=-1, vmax=1)
axes[0].set_xlabel('사인 차원 인덱스 i'); axes[0].set_ylabel('위치')
axes[0].set_title('위치 인코딩 행렬 (사인 차원만)')
fig.colorbar(im, ax=axes[0])

offs = np.arange(-31, 32)
axes[1].plot(offs, [PE[32] @ PE[32 + o] for o in offs])
axes[1].set_xlabel('기준 위치(32)로부터의 거리'); axes[1].set_ylabel('내적')
axes[1].set_title('위치 인코딩 사이의 유사도'); axes[1].grid(alpha=.3)
plt.tight_layout()
plt.savefig('transformer_posenc.png', dpi=150, bbox_inches='tight')
왼쪽 그림은 짝수 차원에 들어가는 사인 성분만 뽑아 그린 것입니다. 홀수 차원의 코사인은 같은 주기를 위상만 바꿔 담고 있어 전체 경향은 같습니다. 왼쪽으로 갈수록 위아래 방향의 줄무늬가 촘촘하고 오른쪽으로 갈수록 성글어지는데, 앞쪽 차원이 짧은 주기로 진동해 바로 옆 위치도 구분하고 뒤쪽 차원은 느리게 변해 넓은 범위를 담는다는 뜻입니다. 오른쪽 절반이 거의 흰색인 것은 그 차원들의 파장이 64를 훌쩍 넘겨 이 길이 안에서는 값이 거의 변하지 않기 때문입니다. 문장이 길어질수록 그 차원들이 비로소 제 역할을 하기 시작합니다.
오른쪽 곡선은 32번 위치의 인코딩과 다른 위치의 인코딩을 내적한 값입니다. 거리 0에서 64로 최대이고, 멀어질수록 완만하게 줄면서 좌우가 대칭입니다. 위치 인코딩이 절대 위치를 담으면서도 상대적인 거리 감각을 함께 전달한다는 뜻입니다.
이 방식의 실용적인 장점은 학습 없이 임의의 길이로 확장된다는 점입니다. 원 논문은 위치 벡터를 학습시키는 방식도 실험했는데 성능이 거의 같았고, 학습이 필요 없는 쪽을 택했다고 밝히고 있습니다. 다만 위에서 본 거리 감각은 부수 효과에 가까워서, 이후 연구들은 상대 위치를 직접 모델링하거나 쿼리와 키를 회전시켜 위치를 주입하는 방식으로 나아갔습니다 [8][9].
5. 부품을 블록으로 조립하기
여기까지가 Transformer의 핵심 부품입니다. 이제 이것들을 어떤 순서로 이어 붙이는지 살펴보겠습니다.
블록 하나는 두 부분으로 이루어집니다. 앞쪽은 멀티헤드 어텐션이고 뒤쪽은 피드포워드 신경망입니다. 어텐션이 토큰끼리 정보를 섞는 담당이라면, 피드포워드는 섞인 정보를 토큰마다 따로 소화하는 담당입니다.
피드포워드 쪽 구조는 단순합니다. 512차원을 2048차원으로 늘리는 완전연결층, ReLU, 다시 512차원으로 줄이는 완전연결층이 전부입니다.
다만 이 신경망이 문장 전체가 아니라 토큰 하나하나에 같은 가중치로 따로 적용된다는 점이 보통의 다층 퍼셉트론과 다릅니다. 512차원 벡터 열 개가 들어오면 열 개가 각각 독립적으로 통과하며 서로 아무 영향을 주지 않습니다. 원 논문이 "위치별(Position-wise)"이라는 수식어를 붙인 이유이며, 이 덕분에 토큰끼리 정보를 주고받는 곳은 어텐션뿐이라는 사실이 확정됩니다. 관점을 바꾸면 CNN 편에서 다룬 커널 크기 1인 합성곱과 같은 연산입니다.
중간 차원이 4배로 넓어지므로 블록 파라미터의 약 3분의 2가 여기에 몰려 있습니다.
두 부분 각각의 뒤에는 잔차 연결과 층 정규화가 붙습니다. 여기서 $\text{Sublayer}$는 방금 말한 두 부품, 즉 멀티헤드 어텐션이나 피드포워드 신경망 중 하나를 가리키고, $x$는 그 부품에 들어가는 $(n, d_{\text{model}})$ 크기의 텐서입니다. 어느 쪽이든 처리 방식이 같으므로 하나의 식으로 묶어 씁니다.
화살표는 계산 결과가 다시 $x$가 되어 다음 부품으로 넘어간다는 뜻입니다. 괄호 안에서 $x$를 한 번 더 더하는 것이 잔차 연결이고, CNN 편에서 다룬 ResNet과 같은 발상입니다 [5]. 부품이 만든 결과로 $x$를 갈아치우는 대신 원래 값에 얹기 때문에, 부품을 건너뛰는 통로가 생겨 기울기가 깊은 층까지 전달됩니다. 층 정규화는 그렇게 더해진 벡터를 토큰마다 평균 0, 분산 1로 맞춥니다 [4]. 블록을 여러 개 쌓아도 값이 발산하거나 소멸하지 않게 하는 장치입니다. 입력과 출력의 모양이 같으므로 블록은 그대로 반복해 쌓을 수 있고, 원 논문은 인코더와 디코더를 각각 6층으로 구성했습니다.
정규화를 어디에 둘 것인가는 이후 꾸준히 다뤄진 주제입니다. 원 논문은 덧셈 뒤에 두었지만 (Post-LN), 부품 앞에 두는 방식(Pre-LN)이 학습을 더 안정시킨다는 연구가 뒤따랐습니다 [3]. 초기화 직후의 기울기만 간단히 재 보아도 경향이 드러납니다.
import torch
import torch.nn as nn

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.shape[-1]
    scores = Q @ K.transpose(-2, -1) / (d_k ** 0.5)
    if mask is not None:
        scores = scores.masked_fill(mask, float('-inf'))
    attn = torch.softmax(scores, dim=-1)
    return attn @ V, attn

# 3절의 MultiHeadAttention과 같은 코드이며 print문만 주석 처리했습니다
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        self.h = n_heads
        self.d_head = d_model // n_heads
        self.qkv = nn.Linear(d_model, 3 * d_model, bias=False)
        self.proj = nn.Linear(d_model, d_model, bias=False)

    def forward(self, x, mask=None):
        B, N, D = x.shape
        qkv = self.qkv(x).reshape(B, N, 3, self.h, self.d_head)
        qkv = qkv.permute(2, 0, 3, 1, 4)
        q, k, v = qkv[0], qkv[1], qkv[2]
        #print("  헤드 분할 후 q:", tuple(q.shape))
        o, a = scaled_dot_product_attention(q, k, v, mask)
        #print("  어텐션 행렬 :", tuple(a.shape))
        o = o.transpose(1, 2).reshape(B, N, D)
        #print("  concat 결과 :", tuple(o.shape))
        return self.proj(o)

class Block(nn.Module):
    def __init__(self, d, h, pre_ln):
        super().__init__()
        self.pre = pre_ln
        self.attn = MultiHeadAttention(d, h)
        self.ff = nn.Sequential(nn.Linear(d, 4 * d), nn.ReLU(), nn.Linear(4 * d, d))
        self.ln1, self.ln2 = nn.LayerNorm(d), nn.LayerNorm(d)

    def forward(self, x):
        if self.pre:
            x = x + self.attn(self.ln1(x))
            x = x + self.ff(self.ln2(x))
        else:
            x = self.ln1(x + self.attn(x))
            x = self.ln2(x + self.ff(x))
        return x

class Stack(nn.Module):
    def __init__(self, L, d, h, pre, vocab):
        super().__init__()
        self.blocks = nn.ModuleList([Block(d, h, pre) for _ in range(L)])
        self.lnf = nn.LayerNorm(d) if pre else nn.Identity()
        self.head = nn.Linear(d, vocab)

    def forward(self, x):
        for b in self.blocks:
            x = b(x)
        return self.head(self.lnf(x))

for L in [6, 12, 24]:
    line = f"L={L:2d}"
    for pre in [False, True]:
        torch.manual_seed(0)
        net = Stack(L, 64, 4, pre, 50)
        torch.manual_seed(1)
        x, y = torch.randn(8, 32, 64), torch.randint(0, 50, (8, 32))
        nn.functional.cross_entropy(net(x).reshape(-1, 50), y.reshape(-1)).backward()
        g = [b.attn.qkv.weight.grad.norm().item() for b in net.blocks]
        line += f" | {'Pre-LN ' if pre else 'Post-LN'} 마지막/첫 블록 = {g[-1]/g[0]:.1f}배"
    print(line)
L= 6 | Post-LN 마지막/첫 블록 = 1.8배 | Pre-LN 마지막/첫 블록 = 1.5배
L=12 | Post-LN 마지막/첫 블록 = 2.5배 | Pre-LN 마지막/첫 블록 = 1.7배
L=24 | Post-LN 마지막/첫 블록 = 3.8배 | Pre-LN 마지막/첫 블록 = 1.5배Post-LN은 깊어질수록 아래쪽 블록의 기울기가 상대적으로 작아져 6층에서 1.8배이던 격차가 24층에서 3.8배로 벌어집니다. 반면 Pre-LN은 층수와 무관하게 1.5~1.7배를 유지합니다. 원 논문이 학습률 워밍업을 필수로 둔 이유도 여기에 있습니다. 다만 이 실험은 초기화 시점의 한 스텝만 본 것이므로 최종 성능 비교로 읽어서는 안 됩니다.
디코더 블록은 여기에 두 가지가 더해집니다.
첫째는 마스크입니다. 1절 위젯의 causal 마스크 토글을 다시 켜 보면, 오른쪽 위 삼각형이 $-\infty$가 되고 softmax 이후 그 자리의 가중치가 정확히 0이 되는 것을 볼 수 있습니다. 디코더는 다음 단어를 예측해야 하므로 정답을 미리 보면 안 되는데, 이 마스크 덕분에 문장 전체를 한 번에 넣고도 각 위치가 "그 시점까지만 아는" 상태로 학습할 수 있습니다. RNN이 순차 처리로 자연스럽게 지키던 규칙을 행렬 연산으로 대체한 셈입니다.
둘째는 인코더-디코더 어텐션입니다. 쿼리는 디코더에서, 키와 값은 인코더에서 가져옵니다. 여기서 헷갈리기 쉬운 것이 디코더 아래쪽으로 들어가는 입력입니다. 그것은 인코더의 출력이 아니라 출력 문장 쪽 토큰들이며, 원문의 정보는 오직 이 부품을 통해서만 합류합니다. 게다가 여섯 개 층이 받는 키와 값은 모두 같습니다. 인코더 1층이 디코더 1층으로 이어지는 것이 아니라 인코더 최상단의 출력 하나를 여섯 층이 공유하므로, 인코더는 문장당 한 번만 돌리고 그 결과를 계속 재사용할 수 있습니다.
그렇다면 디코더 아래로 들어가는 문장은 누가 줄까요. 학습할 때는 정답 번역문을 그대로 넣습니다. 정답을 통째로 주되 마스크로 앞부분만 보이게 하는 방식이며, 이를 Teacher Forcing이라고 부릅니다. 덕분에 모든 위치의 예측을 한 번의 순전파로 동시에 학습할 수 있습니다.
번역할 때는 정답이 없으므로 모델이 직전에 만든 단어를 자기 입력으로 다시 받습니다. 시작 토큰 하나로 출발하는데, 이때는 Self-attention이 볼 것이 자기 자신뿐이라 첫 단어를 정하는 정보는 사실상 전부 인코더-디코더 어텐션에서 옵니다. 그렇게 만든 단어를 뒤에 붙여 다시 넣기를 종료 토큰이 나올 때까지 반복합니다. 학습은 한 번에 끝나지만 생성은 단어 수만큼 순차적으로 돌려야 한다는 뜻이며, 순환을 없앤 이득이 학습 쪽에 크게 몰려 있다는 점을 보여 줍니다.
6. 무엇을 대가로 치렀는가
순환을 없앤 대가는 계산량에 나타납니다. 세 가지 지표로 비교해 보겠습니다.
| 항목 | RNN | Self-attention |
|---|---|---|
| 층당 연산량 | $O(n \cdot d^2)$ | $O(n^2 \cdot d)$ |
| 순차적 연산 횟수 | $O(n)$ | $O(1)$ |
| 최장 의존 경로 | $O(n)$ | $O(1)$ |
두 번째와 세 번째 줄이 Transformer가 얻은 것입니다. RNN은 $n$번을 순서대로 밟아야 하지만 Self-attention은 한 번의 행렬 곱으로 끝나므로 GPU를 가득 채울 수 있습니다. 첫 단어와 마지막 단어 사이의 거리도 RNN에서는 $n$단계지만 어텐션에서는 한 단계이며, 기울기가 $n$번의 곱셈을 거치며 소실되던 문제가 구조적으로 사라집니다.
대가는 첫 번째 줄입니다. $n^2$이 등장하므로 문장이 길어지면 비용이 제곱으로 뜁니다. $d_{\text{model}} = 512$를 기준으로 두 항이 같아지는 지점은 $n = 512$이고, $n = 4096$이면 Self-attention 쪽이 8배 무거워집니다.
이론이 실제로 어떻게 나타나는지 재 보았습니다. 배치 8, $d_{\text{model}} = 512$로 고정하고 시퀀스 길이만 바꿔 가며 순전파와 역전파 1회에 걸리는 시간과 최대 메모리를 측정했습니다. 측정에 쓴 GPU의 물리 메모리는 12 GB입니다. 비교 대상은 어텐션 행렬을 실제로 만드는 단순 구현, 같은 계산을 블록 단위로 처리해 행렬을 메모리에 올리지 않는 퓨전 커널, 그리고 같은 차원의 LSTM입니다.
device = cuda, batch = 8, d_model = 512
     n |         어텐션(단순 구현) |        어텐션(퓨전 커널) |           LSTM
   128 |      0.8 ms /      59 MB |      0.7 ms /      62 MB |      5.2 ms /     100 MB
   256 |      1.5 ms /     130 MB |      1.4 ms /      90 MB |      8.8 ms /     135 MB
   512 |      5.1 ms /     341 MB |      3.7 ms /     135 MB |     18.5 ms /     202 MB
  1024 |     16.3 ms /    1149 MB |     11.2 ms /     223 MB |     39.9 ms /     346 MB
  2048 |     55.5 ms /    4301 MB |     37.7 ms /     400 MB |     71.1 ms /     634 MB
  4096 |   7172.6 ms /   16749 MB |    131.9 ms /     753 MB |    142.8 ms /    1210 MB
네 가지가 눈에 띕니다.
짧은 문장에서는 어텐션이 압도적으로 빠릅니다. $n = 128$에서 LSTM은 5.2 ms인데 어텐션은 0.8 ms로 6배 이상 차이가 납니다. 연산량 자체는 어텐션이 적지 않은데도 이런 결과가 나오는 이유는 순차적 연산 횟수에 있습니다. LSTM은 128번을 순서대로 밟아야 하지만 어텐션은 행렬 곱 몇 번으로 끝나므로 GPU를 가득 채울 수 있습니다. 표에서 LSTM의 시간이 길이에 거의 정비례해 늘어나는 것도 이 사슬 때문입니다. 128 $\to$ 256 $\to$ 512 $\to$ 1024로 갈 때 1.69배, 2.10배, 2.16배씩 증가하며, 짧은 구간에서 2배에 못 미치는 것은 커널 실행 같은 고정 비용이 섞여 있기 때문입니다.
메모리는 이론이 예측한 지점에서 뒤집힙니다. 단순 구현의 메모리는 341 MB $\to$ 1149 MB $\to$ 4301 MB로 길이가 2배 될 때마다 3.4배, 3.7배씩 늘어 $n^2$에 수렴합니다. LSTM은 202 MB $\to$ 346 MB $\to$ 634 MB로 1.7배, 1.8배씩만 늘어납니다. 두 값이 뒤집히는 지점은 $n = 512$ 부근인데, 이는 앞서 계산한 이론적 교차점 $n = d_{\text{model}} = 512$와 정확히 맞아떨어집니다.
시간의 교차점은 더 늦게 옵니다. $n = 2048$에서도 어텐션은 55.5 ms로 LSTM의 71.1 ms보다 빠릅니다. 연산량 비율만 보면 이미 어텐션이 4배 무거워야 하는 구간인데도 그렇습니다. 순차 처리를 없앤 이득이 연산량 증가를 한동안 상쇄한다는 뜻이며, Transformer가 실전에서 빠른 이유가 연산량이 적어서가 아니라 병렬화가 가능해서라는 점을 보여 줍니다.
같은 수식인데 구현에 따라 결과가 전혀 다릅니다. $n = 4096$에서 퓨전 커널은 753 MB만 쓰는데 단순 구현은 16,749 MB를 씁니다. 22배 차이입니다. 어텐션 행렬을 통째로 메모리에 올리지 않고 블록 단위로 나눠 계산한 뒤 필요한 값만 남기기 때문입니다 [10]. 두 방식이 만드는 출력은 수학적으로 동일합니다.
그리고 어느 지점을 넘으면 벽에 부딪힙니다. 위 측정에 쓴 GPU의 물리 메모리는 12 GB입니다. $n = 4096$에서 단순 구현이 요청한 16,749 MB는 그 한계를 넘어섭니다. 드라이버가 부족한 몫을 시스템 메모리로 넘겨 실행을 이어 갔고, 그 결과 시간이 55.5 ms에서 7172.6 ms로 100배 넘게 뛰었습니다. $n^2$이 예측하는 4배와는 전혀 다른 값이며, 이 배수는 측정할 때마다 달라집니다. 같은 코드를 다시 돌리면 3000 ms대가 나오기도 합니다. 순수한 계산이 아니라 그 시점의 메모리 여유에 좌우되는 값이기 때문입니다.
이 숫자는 연산량이 아니라 메모리를 오가는 비용이며, 바로 그 점이 요지입니다. $n^2$의 대가는 연산이 조금씩 무거워지는 형태로만 오지 않습니다. 어느 지점까지는 감당할 만하다가, 어텐션 행렬이 메모리에 들어가지 못하는 순간 성능이 무너집니다. 같은 조건에서 퓨전 커널은 753 MB만 쓰고 131.9 ms에 끝냈습니다. 긴 문맥을 다루려면 구조를 바꾸기 전에 이 행렬을 어떻게 다룰지부터 풀어야 한다는 뜻입니다.
이 $n^2$ 문제는 Transformer 이후 연구의 큰 줄기 하나를 이룹니다. 오늘날 PyTorch의 F.scaled_dot_product_attention이 내부적으로 이런 커널을 선택하며, 위 표의 두 어텐션 열이 그 차이를 보여 줍니다. 긴 문맥을 다루는 모델이 빠르게 늘어난 배경에는 구조 자체의 변화만큼이나 이런 구현 수준의 개선이 있었습니다.
이 절의 측정에 쓴 스크립트는 글 아래에 첨부했습니다. 본문에는 결과만 실었지만 실제로는 워밍업 2회 후 5회 평균을 재고, 메모리가 부족하면 해당 항목을 건너뜁니다. SEQ_LENS와 BATCH만 조정하면 다른 GPU에서도 그대로 돌아가며, 그림의 점선은 실행 중인 GPU의 물리 메모리를 읽어 그리므로 12 GB가 아니어도 각자의 한계선이 표시됩니다.
마치며
Transformer는 딥러닝 아키텍처의 패러다임을 바꾸어 놓았습니다. 순환에 의존하던 구조를 Self-attention으로 대체하면서 병렬 처리가 가능해졌고, 그 덕분에 대규모 데이터로 거대한 모델을 학습시키는 일이 현실이 되었습니다.
Transformer가 한 일을 한 문장으로 줄이면, 시간에 따라 정보를 나르던 구조를 위치 사이의 관계를 한 번에 계산하는 구조로 바꾼 것입니다. 순환이 사라지면서 순서 정보를 따로 넣어 줘야 했고, 내적이 커지는 문제 때문에 $\sqrt{d_k}$로 나눠야 했으며, 모든 쌍을 보는 대가로 $n^2$의 비용을 떠안았습니다. 이 글에서 살펴본 부품들은 대부분 그 교환에서 생긴 보정 장치였습니다.
흥미로운 점은 이 구조가 번역을 위해 설계되었는데도 훨씬 넓은 범위로 퍼졌다는 사실입니다. 인코더만 남겨 문장 이해에 쓰거나 [6], 디코더만 남겨 생성에 쓰는 변형이 나왔고, 이미지를 $16 \times 16$ 조각으로 잘라 토큰처럼 넣자 CNN을 대체할 수 있다는 결과도 나왔습니다 [7]. 앞서 다룬 VQ-VAE나 VQGAN이 이미지를 이산 토큰으로 바꾸는 데 공을 들인 이유도 여기에 있습니다. 일단 무엇이든 토큰의 나열로 바꿔 놓으면, 그다음은 Transformer가 받아 줍니다.
부품 하나하나는 어렵지 않습니다. 행렬 곱과 softmax, 그리고 덧셈이 전부입니다. 지금 돌아가는 대부분의 대형 모델이 이 조합을 반복해 쌓은 것이라는 사실이, 오히려 이 구조를 오래 들여다보게 만드는 이유인 것 같습니다.
📖 참고문헌
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., et al. (2017).
Attention Is All You Need.
NeurIPS 2017. https://arxiv.org/abs/1706.03762 - Bahdanau, D., Cho, K., & Bengio, Y. (2015).
Neural Machine Translation by Jointly Learning to Align and Translate.
ICLR 2015. https://arxiv.org/abs/1409.0473 - Xiong, R., Yang, Y., He, D., Zheng, K., Zheng, S., Xing, C., et al. (2020).
On Layer Normalization in the Transformer Architecture.
ICML 2020. https://arxiv.org/abs/2002.04745 - Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016).
Layer Normalization.
arXiv preprint. https://arxiv.org/abs/1607.06450 - He, K., Zhang, X., Ren, S., & Sun, J. (2016).
Deep Residual Learning for Image Recognition.
CVPR 2016. https://arxiv.org/abs/1512.03385 - Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019).
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding.
NAACL-HLT 2019. https://arxiv.org/abs/1810.04805 - Dosovitskiy, A., Beyer, L., Kolesnikov, A., Weissenborn, D., Zhai, X., Unterthiner, T., et al. (2021).
An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale.
ICLR 2021. https://arxiv.org/abs/2010.11929 - Shaw, P., Uszkoreit, J., & Vaswani, A. (2018).
Self-Attention with Relative Position Representations.
NAACL-HLT 2018. https://arxiv.org/abs/1803.02155 - Su, J., Ahmed, M., Lu, Y., Pan, S., Bo, W., & Liu, Y. (2024).
RoFormer: Enhanced Transformer with Rotary Position Embedding.
Neurocomputing, 568, 127063. https://doi.org/10.1016/j.neucom.2023.127063 - Dao, T., Fu, D. Y., Ermon, S., Rudra, A., & Ré, C. (2022).
FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.
NeurIPS 2022. https://arxiv.org/abs/2205.14135 - Voita, E., Talbot, D., Moiseev, F., Sennrich, R., & Titov, I. (2019).
Analyzing Multi-Head Self-Attention: Specialized Heads Do the Heavy Lifting, the Rest Can Be Pruned.
ACL 2019. https://arxiv.org/abs/1905.09418 - Michel, P., Levy, O., & Neubig, G. (2019).
Are Sixteen Heads Really Better than One?
NeurIPS 2019. https://arxiv.org/abs/1905.10650
🏷️ 코드·그림 출처
본문의 코드는 생성형 AI의 도움을 받아 초안을 작성한 뒤 필자가 검토·수정하고 직접 실행하여 결과를 검증한 것이며, 위젯은 필자가 직접 제작하였습니다. 그림은 모두 위 코드의 실행 결과이고, 6절 벤치마크에 사용한 스크립트는 bench_gpu.7z로 첨부하였습니다. 참고문헌에 수록된 논문의 도표를 전재한 것은 없습니다.