앞선 글에서 우리는 두 가지 군집화 기법을 살펴보았습니다. k-means는 각 군집을 하나의 중심 벡터로 대표하고 제곱 오차의 합을 줄여 나가는 방식이었고, 계층적 군집화는 점들 사이의 거리와 연결 기준을 정한 뒤 병합의 역사를 덴드로그램으로 남기는 방식이었습니다. 그리고 그보다 앞서 다룬 벡터 양자화 이론에서는, 이러한 군집화가 결국 코드북 설계 문제와 같은 뿌리에서 자란다는 점도 확인하였습니다.
그런데 이 두 기법은 겉으로 드러나지 않는 한계를 안고 있습니다. 가장 근본적인 것은 모든 점이 반드시 어딘가에 속해야 한다는 점입니다. 이 알고리즘들에는 "이 점은 어느 군집도 아닙니다"라고 말할 수 있는 문법 자체가 없습니다. 군집의 개수와 형태에 관해서는 두 기법 사이에 정도의 차이가 있습니다. k-means는 군집의 개수 $k$를 미리 요구하고, 결정 경계가 보로노이 분할이므로 각 군집이 반드시 볼록 다면체가 됩니다. 계층적 군집화는 덴드로그램을 그린 뒤 절단 높이로 개수를 정할 수 있고 연결 기준에 따라 형태의 자유도도 달라지지만, 그 대가로 어떤 기준을 고를지와 어디서 자를지를 사람이 판단해야 합니다.
현장에서 얻는 계측 데이터에서는 이 한계가 곧바로 드러납니다. 이동체의 궤적은 가늘고 긴 곡선을 그리고, 회전 기계의 상태 공간은 고리 모양으로 감기며, 라이다 점군에서는 물체의 표면만 찍히므로 벽면이 두께 없는 판으로, 기둥이 속 빈 원통 껍질로 나타납니다. 이런 껍질 모양 군집에서는 무게중심이 물체 안쪽 빈 공간에 놓이므로, 중심 하나로 군집을 대표한다는 발상 자체가 성립하지 않습니다. 게다가 어떤 측정에서든 어디에도 속하지 않는 이상치가 섞여 들어옵니다. 군집의 개수는 애초에 우리가 알고 싶은 대상이지, 우리가 알려 줄 수 있는 정보가 아닌 경우가 많습니다.
DBSCAN(Density-Based Spatial Clustering of Applications with Noise)은 이 지점에서 완전히 다른 출발점을 택합니다. 군집을 "중심에 가까운 점들의 모임"으로 보지 않고 "충분히 조밀한 영역이 끊기지 않고 이어진 덩어리"로 봅니다. Ester 등이 1996년 KDD에서 발표한 이 알고리즘은 2014년 같은 학회에서 Test of Time Award를 받았으며, 30년이 지난 지금도 밀도 기반 군집화의 표준 참조점으로 남아 있습니다.
이 글에서는 DBSCAN의 착상과 형식적 정의, 두 개의 하이퍼파라미터를 정하는 실무적 절차, 그리고 이 알고리즘이 무너지는 지점까지를 순서대로 다루겠습니다. 마지막에는 스펙트로그램에서 검출한 피크 점들을 DBSCAN으로 묶어 신호 성분을 분리하는 예제를 통해, 신호 처리 맥락에서 이 도구를 어떻게 쓸 수 있는지 확인하겠습니다.
1. 왜 밀도인가
먼저 문제를 눈으로 확인하는 것이 좋겠습니다. 성격이 다른 세 가지 2차원 데이터셋에 k-means, Ward 연결 계층적 군집화, DBSCAN을 각각 적용해 보겠습니다.
import unicodedata
import numpy as np
import matplotlib.pyplot as plt

# matplotlib 한글 폰트 설정
plt.rcParams['font.family'] = 'Malgun Gothic'
plt.rcParams['axes.unicode_minus'] = False

from sklearn.datasets import make_moons, make_circles, make_blobs
from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import adjusted_rand_score


def disp_width(s):
    """한글 등 전각 문자를 2칸으로 계산한 표시 폭"""
    return sum(2 if unicodedata.east_asian_width(c) in 'WF' else 1 for c in s)


def lj(s, w):
    return s + ' ' * max(0, w - disp_width(s))


def rj(s, w):
    return ' ' * max(0, w - disp_width(s)) + s


SEED = 42

X_moon, y_moon = make_moons(n_samples=600, noise=0.06, random_state=SEED)
X_circ, y_circ = make_circles(n_samples=600, noise=0.05, factor=0.45, random_state=SEED)
X_blob, y_blob = make_blobs(n_samples=600, centers=3, cluster_std=0.9, random_state=SEED)

datasets = [
    ("초승달",       X_moon, y_moon, 2, 0.20, 5),
    ("동심원",       X_circ, y_circ, 2, 0.20, 5),
    ("등방성 덩어리", X_blob, y_blob, 3, 0.30, 5),
]

header = (lj("데이터셋", 16) + rj("k-means", 10) + rj("Ward", 10)
          + rj("DBSCAN", 10) + rj("군집 수", 9) + rj("잡음점", 9))
print(header)
print('-' * disp_width(header))

fig, axes = plt.subplots(3, 4, figsize=(16, 11))
for row, (name, X, y, k, eps, minpts) in enumerate(datasets):
    Xs = StandardScaler().fit_transform(X)

    km = KMeans(n_clusters=k, n_init=10, random_state=SEED).fit_predict(Xs)
    hc = AgglomerativeClustering(n_clusters=k, linkage='ward').fit_predict(Xs)
    db = DBSCAN(eps=eps, min_samples=minpts).fit_predict(Xs)

    n_cluster = len(set(db)) - (1 if -1 in db else 0)
    n_noise = int(np.sum(db == -1))

    print(lj(name, 16)
          + rj(f"{adjusted_rand_score(y, km):.3f}", 10)
          + rj(f"{adjusted_rand_score(y, hc):.3f}", 10)
          + rj(f"{adjusted_rand_score(y, db):.3f}", 10)
          + rj(str(n_cluster), 9) + rj(str(n_noise), 9))

    for col, (title, lab) in enumerate([("정답", y), ("k-means", km),
                                        ("Ward 연결", hc), ("DBSCAN", db)]):
        ax = axes[row, col]
        ax.scatter(Xs[:, 0], Xs[:, 1], c=lab, s=8, cmap='viridis')
        if col == 3:
            noise = (lab == -1)
            ax.scatter(Xs[noise, 0], Xs[noise, 1], c='red', s=20, marker='x')
        ax.set_title(f"{name} · {title}", fontsize=11)
        ax.set_xticks([]); ax.set_yticks([])

plt.tight_layout()
plt.savefig("clustering_comparison.png", dpi=150)
plt.show()
실행 결과는 다음과 같습니다.
데이터셋           k-means      Ward    DBSCAN  군집 수   잡음점
----------------------------------------------------------------
초승달               0.466     0.618     0.990        2        3
동심원              -0.002    -0.001     0.997        2        1
등방성 덩어리        1.000     1.000     1.000        3        0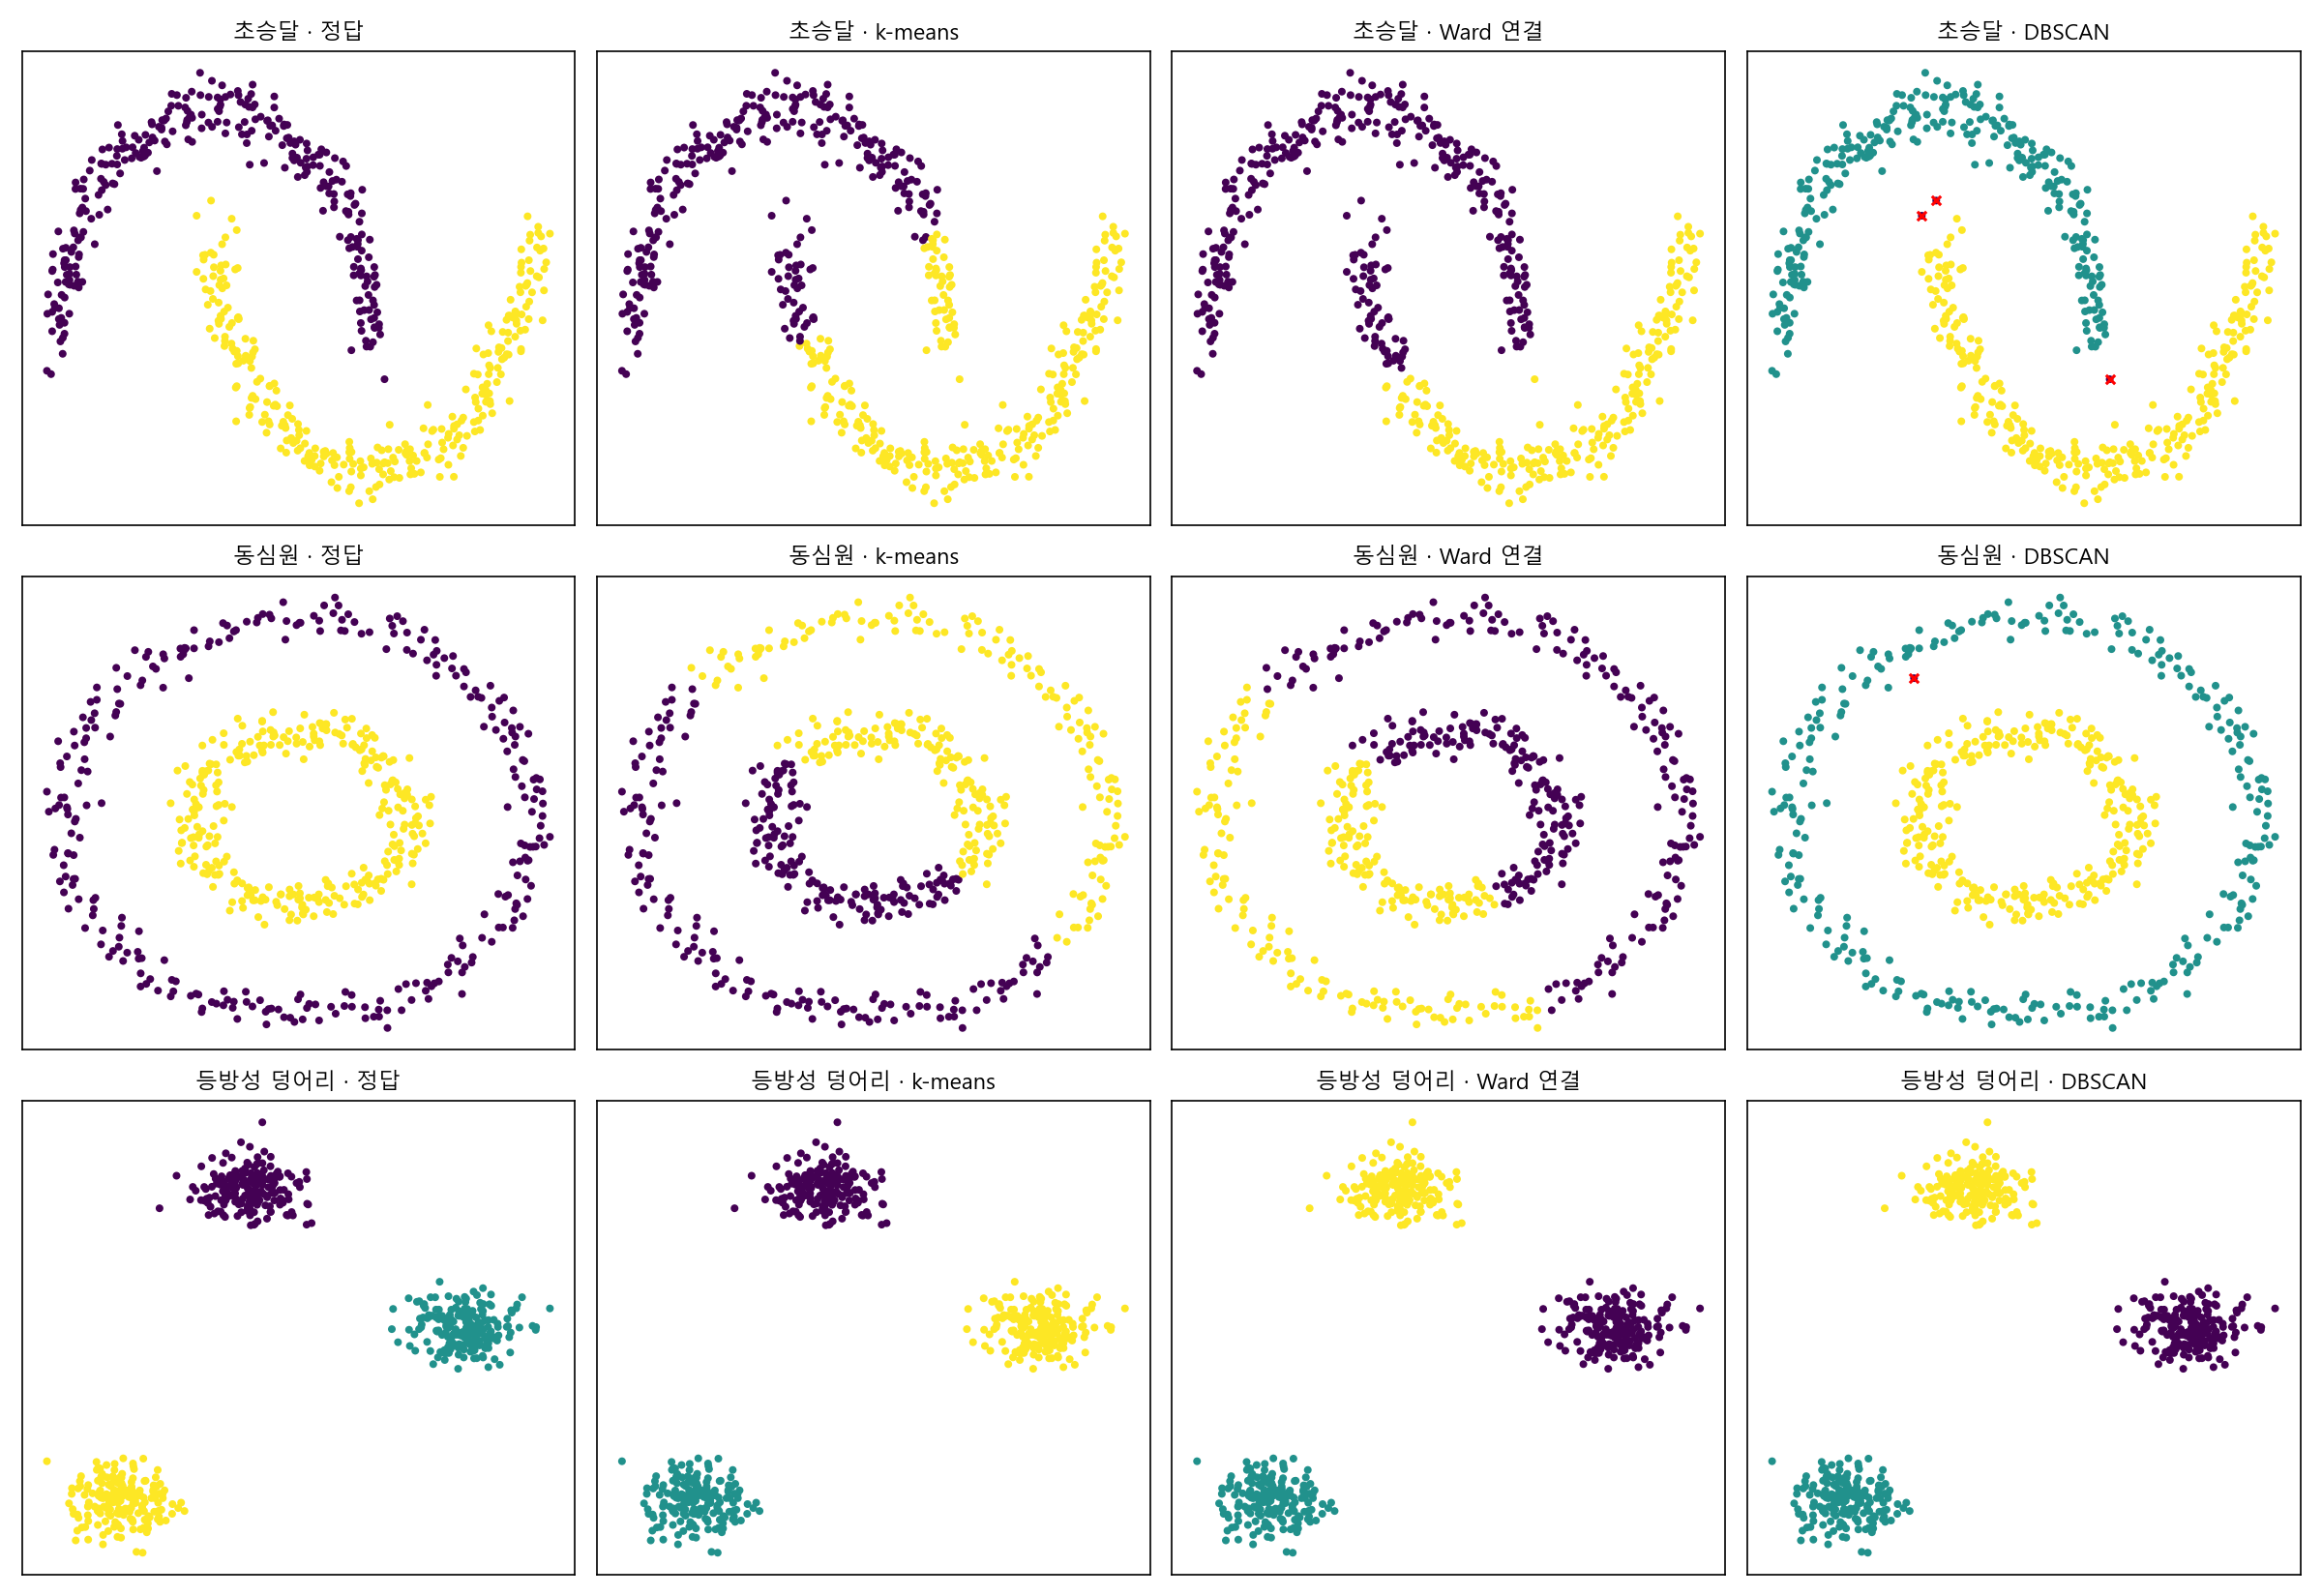
동심원 데이터에서 k-means와 Ward 연결의 ARI(조정 랜드 지수)가 0에 붙어 있다는 점에 주목해 주시기 바랍니다. ARI는 무작위 배정일 때 0이 되도록 보정된 지표이므로, 이 값은 두 알고리즘이 정답에 대해 아무 정보도 주지 못했다는 뜻입니다. k-means는 초기값을 아무리 바꾸어도 결과는 달라지지 않습니다. 안쪽 원과 바깥쪽 고리를 나누는 경계는 곡선(초곡면)인데, k-means가 그릴 수 있는 경계는 직선(초평면)뿐이기 때문입니다. 이것은 수렴 실패가 아니라 모형이 표현할 수 없는 형태를 요구받은 것입니다.
반면 DBSCAN은 두 경우 모두 ARI 0.99 이상으로 정답을 거의 그대로 복원했고, 군집 개수 역시 알려 주지 않았는데도 스스로 2개를 찾아냈습니다. 그러면서 등방성 덩어리 데이터에서는 세 알고리즘 모두 완벽한 결과(ARI 1.000)를 냈습니다. 즉 DBSCAN은 쉬운 문제에서 손해를 보지 않으면서 어려운 문제를 추가로 해결한 것입니다.
여기서 계층적 군집화와의 관계를 짚어 둘 필요가 있습니다. 앞선 글에서 단일 연결(Single Linkage)은 사슬 효과 때문에 가늘고 긴 군집을 잘 잡지만 잡음에 극도로 약하다고 설명하였습니다. 점 하나가 두 군집 사이에 다리를 놓으면 전체가 하나로 병합되어 버리기 때문입니다. DBSCAN의 핵심 착상은 바로 이 약점을 겨냥합니다. 연결은 허용하되, 연결의 자격을 밀도로 심사하는 것입니다. 주변이 충분히 붐비는 점만 다리를 놓을 수 있고, 홀로 떨어진 점은 다리를 놓을 자격이 없습니다.
이 관계는 수사가 아니라 정확한 사실입니다. $\text{MinPts}$를 2로 두면 자기 자신 외에 이웃이 하나만 있어도 다리를 놓을 자격이 생기므로 심사가 사실상 사라지고, DBSCAN은 $\varepsilon$ 높이에서 자른 단일 연결과 같아집니다. 단 하나 다른 점은, 이웃이 하나도 없는 고립점을 DBSCAN은 잡음으로 버리고 단일 연결은 크기 1인 군집으로 남긴다는 것입니다. 그 대응만 두면 두 결과는 완전히 일치합니다.
아래 코드의 예제는 잡음이 0개라 군집 수가 그대로 9개로 맞아떨어집니다.
X = np.random.default_rng(1).random((400, 2)) * 4.0
eps = 0.25

d = DBSCAN(eps=eps, min_samples=2).fit_predict(X)
s = AgglomerativeClustering(n_clusters=None, distance_threshold=eps,
                            linkage='single').fit_predict(X)

print("DBSCAN(MinPts=2) 군집 수   :", len(set(d)) - (1 if -1 in d else 0))
print("DBSCAN 잡음점 수           :", int((d == -1).sum()))
print("단일 연결(높이=eps) 군집 수:", len(set(s)))
print("두 결과의 ARI              :", round(adjusted_rand_score(d, s), 4))
DBSCAN(MinPts=2) 군집 수 : 9
DBSCAN 잡음점 수 : 0
단일 연결(높이=eps) 군집 수: 9
두 결과의 ARI : 1.0따라서 DBSCAN은 단일 연결의 일반화이며, $\text{MinPts}$는 사슬 효과를 억제하는 손잡이라고 이해하시면 정확합니다.
2. 핵심 정의
2.1 밀도 기반 군집화의 두 가지 핵심 매개변수
DBSCAN이 요구하는 입력은 두 개뿐입니다. 반경 $\varepsilon$과 최소 이웃 수 $\text{MinPts}$입니다. 이 둘로부터 모든 개념이 유도됩니다.
$\varepsilon$-이웃은 어떤 점으로부터 거리 $\varepsilon$ 안에 있는 점들의 집합입니다.
$$N_{\varepsilon}(p) = \{ q \in D \mid \text{dist}(p, q) \le \varepsilon \}$$
자기 자신도 이 집합에 포함된다는 점에 유의해 주시기 바랍니다.
두 번째 입력은 최소 데이터 개수인 $\text{MinPts}$입니다. 반경 $\varepsilon$ 원 안에 최소 몇 개의 데이터가 들어 있어야 이 지역을 의미 있는 밀집 지역(군집)으로 인정할 것인지를 결정하는 임계값입니다. scikit-learn의 min_samples는 자기 자신을 포함하여 세는 규약을 따르므로, 원 논문의 $\text{MinPts}$와 그대로 대응합니다.
2.2 데이터 포인트의 세 가지 상태
이제 모든 점은 다음 세 가지 중 하나로 분류됩니다.
- 핵심점(Core Point): $\vert{}N_{\varepsilon}(p)\vert{} \ge \text{MinPts}$ 인 점입니다. 주변이 충분히 붐비므로 군집을 확장시킬 자격을 가집니다.
- 경계점(Border Point): 스스로는 핵심점이 아니지만, 어떤 핵심점의 $\varepsilon$-이웃 안에 들어 있는 점입니다. 군집에 속하기는 하되 확장은 시키지 못합니다.
- 잡음점(Noise Point): 핵심점도 경계점도 아닌 점입니다. 어느 군집에도 속하지 않습니다.
세 번째 범주가 존재한다는 사실이 DBSCAN을 앞선 두 기법과 근본적으로 구분합니다. 이상치 제거를 위한 전처리 단계가 따로 필요 없이, 군집화 그 자체가 이상치 탐지를 겸합니다.
대화형 위젯: 핵심점, 경계점, 잡음점
세 가지 분류 기준을 직접 확인하실 수 있도록 위젯을 준비했습니다. 반경 $\varepsilon$을 움직이면서 각 점이 어떻게 분류되는지, 점 하나를 짚어 그 $\varepsilon$-이웃에 몇 개가 들어 있는지 살펴보시기 바랍니다. $\text{MinPts} = 4$로 고정되어 있습니다.
$\varepsilon$을 키워 가면 잡음점이 경계점으로, 경계점이 핵심점으로 바뀌어 갑니다. 그리고 핵심점들이 서로 이어지면서 군집이 자라납니다. 이 "이어짐"을 정확히 정의하는 것이 다음 절의 과제입니다.
2.3 군집의 확장 메커니즘: 군집의 정의 및 점들 사이의 관계
점들 사이의 관계는 세 단계로 정의됩니다.
직접 밀도 도달(Directly Density-reachable): 점 $q$가 핵심점 $p$의 $\varepsilon$-이웃 안에 있으면, $q$는 $p$로부터 직접 밀도 도달 가능합니다. 즉 아래 두 조건이 동시에 성립합니다.
밀도 도달(Density-reachable): 직접 밀도 도달 관계를 사슬처럼 이은 것입니다. $p = p_1, p_2, \dots, p_m = q$ 인 점열이 존재하여 각 $p_{j+1}$이 $p_j$로부터 직접 밀도 도달 가능하면, $q$는 $p$로부터 밀도 도달 가능합니다.
밀도 연결(Density-connected): 어떤 점 $o$가 존재하여 $p$와 $q$가 모두 $o$로부터 밀도 도달 가능하면, $p$와 $q$는 밀도 연결되어 있습니다.
여기서 대칭성 문제를 반드시 짚고 넘어가야 합니다. 밀도 도달 관계는 대칭이 아닙니다. 핵심점 $p$에서 경계점 $q$로는 도달할 수 있지만, $q$는 핵심점이 아니므로 $q$에서 $p$로는 도달할 수 없습니다. 반면 밀도 연결 관계는 정의상 대칭입니다. DBSCAN이 군집을 밀도 도달이 아니라 밀도 연결로 정의하는 이유가 바로 여기에 있습니다. 대칭적이지 않은 관계로는 군집이라는 동치류를 만들 수 없기 때문입니다.
군집의 정의는 다음 두 조건을 만족하는 공집합이 아닌 부분집합 $C$입니다.
- 극대성(Maximality): $p \in C$이고 $q$가 $p$로부터 밀도 도달 가능하면 $q \in C$입니다.
- 연결성(Connectivity): $C$의 임의의 두 점은 서로 밀도 연결되어 있습니다.
정리하면, 하나의 군집은 결국 핵심점들이 $\varepsilon$ 반경으로 서로 이어진 연결 성분 하나와, 그 성분에 매달린 경계점들의 합입니다. 이렇게 보면 DBSCAN이 왜 임의의 형태를 다룰 수 있는지가 분명해집니다. 군집의 모양을 결정하는 것은 어떤 파라미터화된 곡면이 아니라 데이터 자체의 연결 구조이기 때문입니다.
3. 알고리즘 절차와 계산량
절차 자체는 짧습니다.
DBSCAN(D, eps, MinPts):
    모든 점을 미방문으로 표시
    C = 0
    for each 미방문 점 p in D:
        p를 방문으로 표시
        Neighbors = RegionQuery(p, eps)
        if |Neighbors| < MinPts:
            p를 잡음으로 잠정 표시      # 나중에 경계점으로 승격될 수 있음
        else:
            C = C + 1
            ExpandCluster(p, Neighbors, C, eps, MinPts)

ExpandCluster(p, Neighbors, C, eps, MinPts):
    p를 군집 C에 배정
    for each 점 q in Neighbors:        # 순회 중 Neighbors 가 확장됨
        if q 가 미방문:
            q를 방문으로 표시
            Nq = RegionQuery(q, eps)
            if |Nq| >= MinPts:         # q 도 핵심점이면 이웃을 대기열에 추가
                Neighbors = Neighbors ∪ Nq
        if q 가 아직 어느 군집에도 속하지 않으면:
            q를 군집 C에 배정
여기서 두 가지를 주의 깊게 보아야 합니다. 첫째, 잡음으로 표시한 점을 나중에 다시 군집에 넣을 수 있도록 열어 두었습니다. 처음 방문했을 때는 이웃이 부족했더라도, 이후 다른 핵심점의 이웃으로 발견되면 경계점으로 승격됩니다. 둘째, ExpandCluster 안에서 이웃 집합을 순회하는 도중에 그 집합 자체가 커집니다. 이것이 밀도 도달 사슬을 따라가는 너비 우선 탐색에 해당합니다.
계산량의 지배 항은 영역 질의(RegionQuery)입니다. 각 점에 대해 정확히 한 번씩 호출되므로 총 $n$회이고, 질의 하나의 비용이 전체 복잡도를 결정합니다.
- 아무 색인 없이 전수 비교하면 질의당 $O(n)$이므로 전체는 $O(n^2)$입니다.
- k-d 트리나 R 트리 같은 공간 색인을 쓰면 저차원에서 질의당 평균 $O(\log n)$이 되어 전체 $O(n \log n)$으로 떨어집니다.
- 다만 차원이 높아지면 색인의 가지치기 효율이 급격히 나빠져 사실상 $O(n^2)$으로 되돌아갑니다. 실무 경험상 20차원 부근부터 k-d 트리의 이점이 사라지기 시작합니다.
메모리 측면에서 계층적 군집화와의 차이는 결정적입니다. 계층적 군집화는 $n \times n$ 거리 행렬을 필요로 하므로 $O(n^2)$ 메모리를 소비하고, 이 때문에 수만 점 규모에서 이미 실행이 어려워집니다. DBSCAN은 거리 행렬을 통째로 들고 있을 필요가 없으므로 메모리는 본질적으로 $O(n)$입니다. 원 논문의 DBSCAN이 수십만 점 규모를 감당할 수 있는 이유가 여기에 있습니다.
다만 이는 알고리즘 자체의 성질이고, 구현은 다를 수 있습니다. scikit-learn은 이웃 질의를 한꺼번에 계산하므로 실제 메모리는 평균 이웃 수에 비례해 늘어나며, $\varepsilon$이 크고 $\text{MinPts}$가 작으면 최악의 경우 $O(n^2)$까지 갑니다. 대규모 점군에서는 NearestNeighbors.radius_neighbors_graph(X, mode='distance')로 희소 이웃 행렬을 미리 만들어 metric='precomputed'로 넘기는 방법이 안전합니다. mode를 생략하면 거리 대신 연결 여부만 담긴 0/1 행렬이 만들어집니다. $\varepsilon$이 1보다 작으면 저장된 값 1이 전부 이웃 조건을 통과하지 못해 모든 점이 잡음으로 판정되고, 1보다 크면 반대로 통과해 우연히 정상 결과가 나옵니다. 어느 쪽이든 거리 정보가 사라진 상태이므로 반드시 지정해야 합니다.
3.1 경계점이 남기는 미세한 비결정성
앞의 의사코드에서 q 가 아직 어느 군집에도 속하지 않으면 이라는 조건에 주목해 주시기 바랍니다. 어떤 경계점이 서로 다른 두 군집의 핵심점 양쪽 모두의 $\varepsilon$-이웃에 들어 있다면, 그 점은 먼저 도착한 군집에 배정됩니다. 즉 입력 순서에 따라 결과가 달라집니다.
일부러 그런 상황을 만들어 확인해 보겠습니다.
eps, MinPts = 0.25, 4
xs = np.array([-0.20, -0.15, -0.10, 0.00,   0.25,   0.50, 0.60, 0.65, 0.70])
X = np.stack([xs, np.zeros_like(xs)], axis=1)
names = ['A1', 'A2', 'A3', 'A4', '경계점', 'B1', 'B2', 'B3', 'B4']

db = DBSCAN(eps=eps, min_samples=MinPts).fit(X)
core = np.zeros(len(X), bool)
core[db.core_sample_indices_] = True
print("핵심점 여부:", dict(zip(names, core.astype(int).tolist())))

count = {}
for s in range(12):
    p = np.random.default_rng(s).permutation(len(X))
    lab = DBSCAN(eps=eps, min_samples=MinPts).fit_predict(X[p])
    back = np.empty_like(lab)
    back[p] = lab
    key = 'A쪽' if back[4] == back[0] else ('B쪽' if back[4] == back[5] else '잡음')
    count[key] = count.get(key, 0) + 1

print("입력 순서 12회 변경 시 경계점의 귀속:", count)
핵심점 여부: {'A1': 1, 'A2': 1, 'A3': 1, 'A4': 1, '경계점': 0, 'B1': 1, 'B2': 1, 'B3': 1, 'B4': 1}
입력 순서 12회 변경 시 경계점의 귀속: {'B쪽': 6, 'A쪽': 6}정확히 반씩 갈렸습니다. 다만 이 비결정성의 범위를 오해하지는 말아야 합니다. 핵심점 집합과 잡음점 집합은 입력 순서와 무관하게 언제나 동일하며, 군집의 개수도 바뀌지 않습니다. 달라지는 것은 양쪽에서 손을 뻗는 경계점의 소속뿐입니다. 그럼에도 재현성이 요구되는 파이프라인이라면 입력 정렬을 고정하거나, 경계점을 아예 잡음으로 처리하는 변형(DBSCAN*)을 사용하는 편이 안전합니다.
4. $\varepsilon$과 $\text{MinPts}$를 정하는 법
k-means가 $k$를 물었다면 DBSCAN은 $\varepsilon$과 $\text{MinPts}$를 묻습니다. 파라미터의 개수가 오히려 늘었으니 손해가 아니냐고 생각하실 수 있습니다만, 성격이 다릅니다. $k$는 답의 일부(군집 개수)를 미리 요구하는 반면, $\varepsilon$과 $\text{MinPts}$는 "얼마나 조밀해야 군집으로 인정할 것인가"라는 관측 척도를 요구합니다. 후자는 측정 장비의 분해능이나 물리적 도메인 지식으로부터 유도할 수 있는 경우가 많습니다.
$\text{MinPts}$ 먼저 정합니다. 통용되는 지침은 다음과 같습니다.
- 차원 $d$에 대해 $\text{MinPts} \ge d + 1$이 최소 조건입니다. $d + 1$보다 작으면 $d$차원 초평면 위의 점들만으로도 핵심점이 되어 버려 밀도의 의미가 흐려집니다.
- 실무 경험칙은 $\text{MinPts} = 2d$입니다. 2차원이면 4 또는 5가 흔히 쓰이는 값입니다.
- 잡음이 많거나 데이터가 크면 $\text{MinPts}$를 키웁니다. $\text{MinPts}$가 클수록 잡음 판정이 엄격해지고 사슬 효과가 억제됩니다.
$\varepsilon$은 k-거리 그래프로 정합니다. 여기서의 $k$는 군집 개수가 아니라 이웃의 순번을 뜻합니다. 모든 점에 대해 $k$번째 최근접 이웃까지의 거리($k = \text{MinPts} - 1$)를 구한 뒤 내림차순으로 정렬하여 그립니다. 군집 내부의 점들은 이 거리가 작고 잡음점은 크므로, 곡선에 무릎(knee)이 나타나는 지점이 두 집단을 가르는 자연스러운 경계가 됩니다.
from sklearn.neighbors import NearestNeighbors

X, y = make_moons(n_samples=600, noise=0.06, random_state=SEED)
Xs = StandardScaler().fit_transform(X)

MinPts = 5
nn = NearestNeighbors(n_neighbors=MinPts).fit(Xs)
dist, _ = nn.kneighbors(Xs)
kdist = np.sort(dist[:, -1])[::-1]

# 무릎점 근사: 양 끝점을 잇는 직선에서 수직 거리가 가장 먼 점
n = len(kdist)
idx = np.arange(n, dtype=float)
p1 = np.array([0.0, kdist[0]])
p2 = np.array([n - 1.0, kdist[-1]])
u = (p2 - p1) / np.linalg.norm(p2 - p1)
pts = np.stack([idx, kdist], axis=1) - p1
perp = np.linalg.norm(pts - (pts @ u)[:, None] * u, axis=1)
knee = int(np.argmax(perp))
eps_auto = kdist[knee]

print(f"MinPts = {MinPts}")
print(f"무릎점 인덱스 = {knee}, 자동 추정 eps = {eps_auto:.4f}")
print(f"k-거리 분포: 최소 {kdist.min():.4f}, "
      f"중앙값 {np.median(kdist):.4f}, 최대 {kdist.max():.4f}\n")

print(rj('eps', 8) + rj('군집 수', 10) + rj('잡음점', 9) + rj('ARI', 9))
for eps in [0.05, 0.10, 0.15, eps_auto, 0.20, 0.30, 0.40, 0.50]:
    lab = DBSCAN(eps=eps, min_samples=MinPts).fit_predict(Xs)
    nc = len(set(lab)) - (1 if -1 in lab else 0)
    nz = int((lab == -1).sum())
    tag = "  <- 자동 추정" if abs(eps - eps_auto) < 1e-12 else ""
    print(rj(f"{eps:.3f}", 8) + rj(str(nc), 10) + rj(str(nz), 9)
          + rj(f"{adjusted_rand_score(y, lab):.3f}", 9) + tag)

plt.figure(figsize=(8, 5))
plt.plot(kdist, lw=1.8)
plt.axhline(eps_auto, color='r', ls='--',
            label=f'추정 eps = {eps_auto:.3f}')
plt.axvline(knee, color='gray', ls=':')
plt.xlabel('내림차순 정렬한 점 순번')
plt.ylabel(f'{MinPts - 1}번째 최근접 이웃까지의 거리')
plt.title('k-거리 그래프')
plt.legend(); plt.grid(alpha=0.3); plt.tight_layout()
plt.savefig("k-distance.png", dpi=150)
plt.show()
MinPts = 5
무릎점 인덱스 = 57, 자동 추정 eps = 0.1281
k-거리 분포: 최소 0.0337, 중앙값 0.0834, 최대 0.3434
eps 군집 수 잡음점 ARI
0.050 11 533 0.002
0.100 15 50 0.293
0.150 2 13 0.957
0.128 2 19 0.938 <- 자동 추정
0.200 2 3 0.990
0.300 2 0 1.000
0.400 1 0 0.000
0.500 1 0 0.000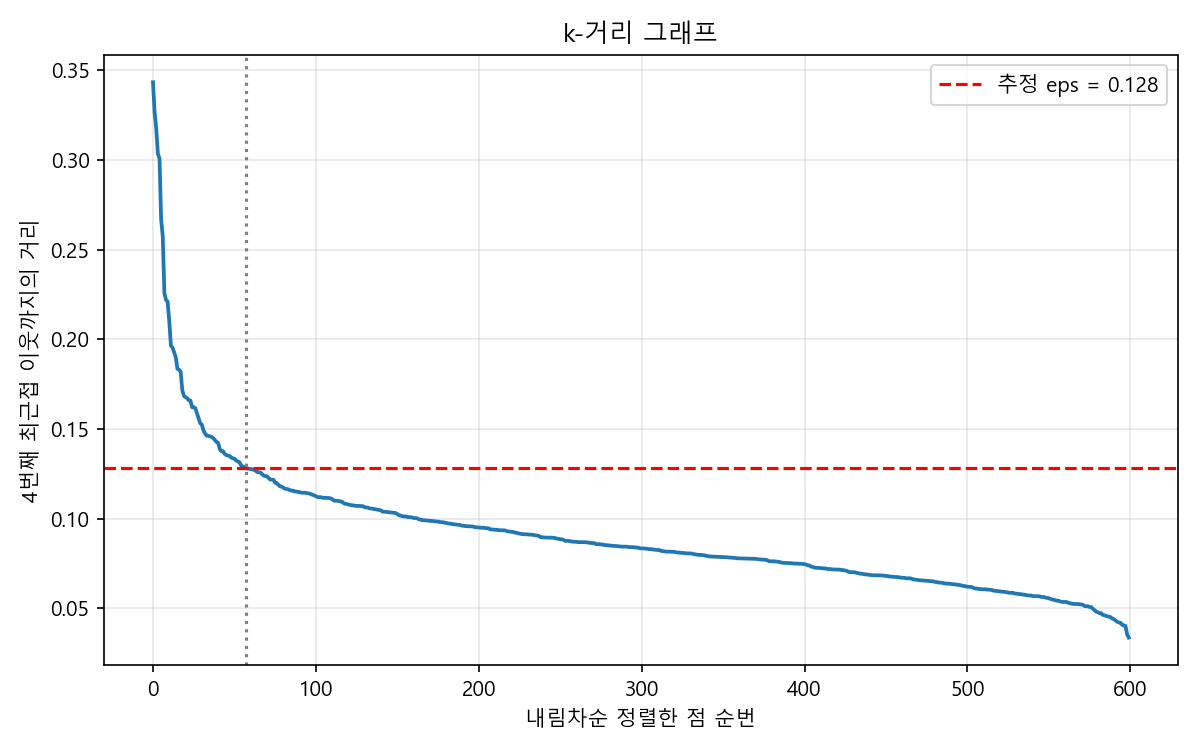
위 실행 결과로 생성된 표에서 읽어야 할 것이 세 가지 있습니다.
첫째, k-거리 그래프의 무릎은 최적값이 아니라 출발점입니다. 자동 추정된 0.128은 ARI 0.938로 나쁘지 않은 결과를 주었지만, 최적인 0.30(ARI 1.000)과는 거리가 있습니다. 무릎점 추정은 탐색 범위를 좁혀 주는 도구이지 최종 답이 아닙니다.
둘째, $\varepsilon$이 너무 작을 때의 실패 양상은 두 단계로 나타납니다. $\varepsilon = 0.05$에서는 600점 중 533점이 잡음으로 버려집니다. 조금 키운 $\varepsilon = 0.10$에서는 잡음은 50점으로 줄지만 군집이 15개로 파편화되어 ARI는 0.293에 그칩니다. 잡음 비율만 보고 판단하면 후자를 개선으로 오인하기 쉬우므로, 군집 개수와 함께 보아야 합니다.
셋째, $\varepsilon$이 커질 때의 실패는 완만하지 않고 절벽처럼 옵니다. 0.30에서 완벽했던 결과가 0.40에서 군집 1개로 붕괴하며 ARI가 0으로 떨어집니다. 두 초승달을 잇는 다리가 놓이는 순간 되돌릴 방법이 없습니다. 실무에서는 $\varepsilon$을 넉넉히 잡기보다 다소 작게 잡고 잡음점을 사후에 검토하는 편이 안전합니다.
한 가지 더 강조하고 싶은 점이 있습니다. $\varepsilon$은 절대적인 거리 값이므로 특징의 단위와 스케일에 직접 종속됩니다. 위 코드에서 StandardScaler를 먼저 적용한 것은 형식적인 절차가 아닙니다. 축마다 단위가 다른 데이터를 그대로 넣으면 값의 범위가 큰 축이 거리를 독점하여, 사실상 그 축 하나로만 군집화한 결과가 나옵니다. 이 문제는 6절에서 구체적인 수치로 다시 확인하겠습니다.
5. 알고리즘의 현실적인 한계
5.1 밀도 편차: 하나의 $\varepsilon$으로 감당되지 않는 경우
DBSCAN의 가장 근본적인 제약은 정의 자체에서 나옵니다. $\varepsilon$과 $\text{MinPts}$가 전역 상수이므로, 데이터 전체에 하나의 밀도 기준만 적용됩니다. 군집마다 밀도가 크게 다르면 어느 한쪽은 반드시 희생됩니다.
조밀한 군집 두 개와 희박한 군집 하나를 만들어 확인해 보겠습니다.
from collections import Counter

rng = np.random.default_rng(42)
A = rng.normal([0.0, 0.0], 0.20, size=(400, 2))   # 조밀
B = rng.normal([1.5, 0.0], 0.20, size=(400, 2))   # 조밀, A와 가까움
C = rng.normal([6.0, 0.0], 0.90, size=(120, 2))   # 희박, 멀리 떨어짐
X = np.vstack([A, B, C])
y = np.concatenate([np.zeros(400), np.ones(400), np.full(120, 2)]).astype(int)


def major_label(lab, mask):
    c = Counter(lab[mask]); c.pop(-1, None)
    return c.most_common(1)[0][0] if c else None


print(f"{'eps':>7}{'군집 수':>9}{'A-B 분리':>11}{'C 잡음%':>10}{'C 조각':>8}{'ARI':>8}")
for eps in [0.10, 0.15, 0.20, 0.25, 0.30, 0.35, 0.40, 0.50, 0.60]:
    lab = DBSCAN(eps=eps, min_samples=5).fit_predict(X)
    nc = len(set(lab)) - (1 if -1 in lab else 0)
    la, lb = major_label(lab, y == 0), major_label(lab, y == 1)
    sep = "O" if (la is not None and lb is not None and la != lb) else "X"
    mC = (y == 2)
    print(f"{eps:>7.2f}{nc:>12d}{sep:>13}"
          f"{100 * np.mean(lab[mC] == -1):>12.1f}"
          f"{len(set(lab[mC]) - {-1}):>10d}"
          f"{adjusted_rand_score(y, lab):>8.3f}")

for name, S in [("조밀 군집 A", A), ("조밀 군집 B", B), ("희박 군집 C", C)]:
    d, _ = NearestNeighbors(n_neighbors=5).fit(X).kneighbors(S)
    print(f"{name}의 4-최근접 이웃 거리 중앙값 = {np.median(d[:, -1]):.4f}")
eps 군집 수 A-B 분리 C 잡음% C 조각 ARI
0.10 2 O 100.0 0 0.903
0.15 2 O 100.0 0 0.977
0.20 3 O 82.5 1 0.987
0.25 6 O 60.0 4 0.980
0.30 6 O 35.0 4 0.976
0.35 4 O 24.2 2 0.984
0.40 3 X 20.0 2 0.307
0.50 3 X 12.5 2 0.312
0.60 2 X 8.3 1 0.316
조밀 군집 A의 4-최근접 이웃 거리 중앙값 = 0.0391
조밀 군집 B의 4-최근접 이웃 거리 중앙값 = 0.0422
희박 군집 C의 4-최근접 이웃 거리 중앙값 = 0.3147표를 세로로 읽으면 문제가 선명하게 드러납니다. $\varepsilon \le 0.35$ 구간에서는 A와 B가 분리되지만 (O) 희박한 군집 C는 최소 24%가 잡음으로 버려지고 조각까지 납니다. $\varepsilon \ge 0.40$이 되면 C의 회수율은 좋아지지만 그 순간 A와 B가 하나로 병합되어(X) ARI가 0.98에서 0.31로 무너집니다. 세 군집을 동시에 만족시키는 $\varepsilon$은 존재하지 않습니다.
원인은 명확합니다. 조밀 군집의 4-최근접 이웃 거리 중앙값은 약 0.04인 반면 희박 군집은 약 0.31로, 8배가량 차이가 납니다. 하나의 반경으로 이 격차를 덮을 방법이 없습니다.
이 한계를 정면으로 겨냥한 확장이 두 가지 있습니다.
OPTICS(Ordering Points To Identify the Clustering Structure)는 $\varepsilon$을 하나로 고정하는 대신, 점들을 밀도 순서로 정렬하면서 각 점의 도달 거리(reachability distance)를 기록합니다. 그 결과로 얻는 도달 거리 그래프는 여러 $\varepsilon$에 대응하는 군집 구조를 한 장에 담고 있으며, 계곡의 깊이를 기준으로 군집을 추출합니다.
HDBSCAN은 여기서 한 걸음 더 나아가, 모든 $\varepsilon$에 대한 DBSCAN 결과를 계층 구조로 만든 뒤 군집의 안정성(Persistence)을 기준으로 서로 다른 밀도의 군집들을 동시에 선택합니다. 사용자가 정할 것은 $\varepsilon$이 아니라 최소 군집 크기 하나뿐이므로 실무 적용이 훨씬 수월합니다. scikit-learn 1.3 이후로는 별도 패키지 설치 없이 사용할 수 있습니다.
from sklearn.cluster import OPTICS, HDBSCAN

opt = OPTICS(min_samples=5, xi=0.10, min_cluster_size=0.05).fit_predict(X)
hdb = HDBSCAN(min_cluster_size=10, copy=True).fit_predict(X)

for name, lab in [("OPTICS  ", opt), ("HDBSCAN ", hdb)]:
    nc = len(set(lab)) - (1 if -1 in lab else 0)
    print(f"{name}: 군집 {nc}개, 전체 잡음 {int((lab == -1).sum()):>3d}개, "
          f"C 잡음 {100 * np.mean(lab[y == 2] == -1):>5.1f}%, "
          f"ARI {adjusted_rand_score(y, lab):.3f}")
OPTICS : 군집 3개, 전체 잡음 31개, C 잡음 25.8%, ARI 0.986
HDBSCAN : 군집 3개, 전체 잡음 1개, C 잡음 0.8%, ARI 0.999HDBSCAN은 전역 $\varepsilon$ 없이 세 군집을 모두 복원했고 잡음으로 버린 점은 전체 920점 중 1점뿐입니다. DBSCAN이 어떤 $\varepsilon$으로도 도달하지 못했던 지점입니다.
※ 이 비교에서 OPTICS의 결과는 xi 값에 상당히 민감합니다. 위 결과는 xi=0.10 기준이며, xi=0.05 에서는 ARI가 0.699까지 떨어졌습니다. OPTICS를 쓰실 때는 도달 거리 그래프를 직접 그려 계곡 구조를 눈으로 확인하신 뒤 xi 를 정하시기를 권합니다.
5.2 고차원에서의 무력화
두 번째 제약은 차원의 저주입니다. 차원이 높아지면 임의의 두 점 사이 거리가 서로 비슷해지는 거리 집중(distance concentration) 현상이 나타나고, 최근접 이웃과 최원접 이웃의 거리 비가 1에 수렴합니다. 이렇게 되면 "가까운 점과 먼 점"이라는 구분 자체가 무의미해지므로, 어떤 $\varepsilon$을 고르든 모든 점이 이웃이 되거나 아무도 이웃이 아니게 됩니다. 앞서 본 k-거리 그래프의 무릎도 함께 사라집니다.
여기에 공간 색인의 효율 저하까지 겹치므로, 고차원 데이터에 DBSCAN을 직접 적용하는 것은 대체로 좋은 선택이 아닙니다. PCA나 오토인코더, UMAP 등으로 차원을 먼저 낮춘 뒤 적용하시거나, 코사인 거리처럼 해당 도메인에서 의미가 유지되는 거리 척도를 쓰시는 편이 낫습니다.
5.3 대표 벡터가 없다는 점
앞서 다룬 벡터 양자화 이론의 관점에서 짚어 둘 부분이 있습니다. k-means는 군집화의 결과로 곧바로 코드북, 즉 대표 벡터의 집합을 내놓습니다. 이것이 LBG 알고리즘이 벡터 양자화의 표준 설계 도구가 된 이유였습니다.
DBSCAN은 대표 벡터를 만들지 않습니다. 결과는 레이블 배열뿐입니다. 사후에 각 군집의 평균을 계산할 수는 있으나, 비볼록 군집에서는 그 평균점이 군집 바깥에 놓이는 일이 흔합니다. 초승달 모양 군집의 무게중심은 초승달의 오목한 안쪽 빈 공간에 위치합니다. 따라서 DBSCAN은 코드북 설계용 도구가 아닙니다. 이 알고리즘의 자리는 압축이 아니라 구조 발견과 이상치 탐지입니다.
6. 신호 처리에서의 활용: 스펙트로그램 성분 분리
이제 신호 처리 맥락의 예제를 하나 다루겠습니다. 시간-주파수 평면에서 검출한 피크 점들은 각 신호 성분을 따라 가늘고 긴 궤적을 이룹니다. 선형 처프는 대각선을, 정현파는 수평선을 그립니다. 군집의 개수를 미리 알 수 없고, 모양이 볼록하지 않으며, 잡음 바닥에서 온 가짜 피크가 섞인다는 세 조건이 모두 성립하므로 DBSCAN에 잘 맞는 문제입니다.
500 Hz에서 2500 Hz로 올라가는 선형 처프, 3200 Hz의 정상 정현파, 그리고 700 Hz에서 0.2초간 지속되는 짧은 버스트를 섞고 잡음을 더한 신호를 만들어 보겠습니다.
from scipy.signal import stft, chirp
from scipy.ndimage import maximum_filter1d

rng = np.random.default_rng(0)
fs, T = 8000, 2.0
t = np.arange(int(fs * T)) / fs

x = 0.9 * chirp(t, f0=500, f1=2500, t1=T, method='linear')

tone = np.zeros_like(t)
m = (t >= 0.30) & (t <= 1.70)
tone[m] = 0.8 * np.sin(2 * np.pi * 3200 * t[m])

burst = np.zeros_like(t)
b = (t >= 1.20) & (t <= 1.40)
burst[b] = 1.0 * np.sin(2 * np.pi * 700 * t[b])

x = x + tone + burst + 0.25 * rng.standard_normal(t.size)

# STFT 후 프레임별 국소 최대점 중 상위 15 dB 이내만 피크로 채택
f, tt, Z = stft(x, fs=fs, nperseg=256, noverlap=192, window='hann')
S = np.abs(Z)
Sdb = 20 * np.log10(S + 1e-12)
loc = (S == maximum_filter1d(S, size=5, axis=0))
fi, ti = np.nonzero(loc & (Sdb > Sdb.max() - 15))

print(f"STFT 크기 {S.shape}, df = {f[1] - f[0]:.2f} Hz, "
      f"dt = {(tt[1] - tt[0]) * 1000:.1f} ms")
print(f"검출된 피크 점: {fi.size}개\n")

# [A] 빈 인덱스 좌표 — 두 축의 눈금 간격이 1로 통일됨
P = np.stack([ti.astype(float), fi.astype(float)], axis=1)
print("[A] 빈 인덱스 좌표를 사용한 경우")
for eps in [2.0, 2.5, 3.0, 4.0, 5.0, 8.0]:
    lab = DBSCAN(eps=eps, min_samples=4).fit_predict(P)
    nc = len(set(lab)) - (1 if -1 in lab else 0)
    print(f"    eps={eps:>4.1f} -> 군집 {nc}개, 잡음 {int((lab == -1).sum())}개")

lab = DBSCAN(eps=3.0, min_samples=4).fit_predict(P)
print()
for c in sorted(set(lab) - {-1}):
    s = (lab == c)
    print(f"    군집 {c}: {s.sum():3d}점 | "
          f"t {tt[ti[s]].min():.2f}~{tt[ti[s]].max():.2f} s | "
          f"f {f[fi[s]].min():.0f}~{f[fi[s]].max():.0f} Hz")

# [B] 물리 단위(초, Hz) 좌표를 그대로 사용한 경우
Q = np.stack([tt[ti], f[fi]], axis=1)
print("\n[B] 물리 단위(초, Hz) 좌표를 그대로 사용한 경우")
for eps in [1.0, 10.0, 50.0, 100.0, 200.0]:
    lab2 = DBSCAN(eps=eps, min_samples=4).fit_predict(Q)
    nc = len(set(lab2)) - (1 if -1 in lab2 else 0)
    print(f"    eps={eps:>6.1f} -> 군집 {nc}개, 잡음 {int((lab2 == -1).sum())}개")
STFT 크기 (129, 251), df = 31.25 Hz, dt = 8.0 ms
검출된 피크 점: 454개
[A] 빈 인덱스 좌표를 사용한 경우
eps= 2.0 -> 군집 3개, 잡음 2개
eps= 2.5 -> 군집 3개, 잡음 0개
eps= 3.0 -> 군집 3개, 잡음 0개
eps= 4.0 -> 군집 3개, 잡음 0개
eps= 5.0 -> 군집 3개, 잡음 0개
eps= 8.0 -> 군집 3개, 잡음 0개
군집 0: 251점 | t 0.00~2.00 s | f 500~2500 Hz
군집 1: 26점 | t 1.20~1.40 s | f 688~688 Hz
군집 2: 177점 | t 0.30~1.70 s | f 3156~3219 Hz
[B] 물리 단위(초, Hz) 좌표를 그대로 사용한 경우
eps= 1.0 -> 군집 58개, 잡음 24개
eps= 10.0 -> 군집 58개, 잡음 24개
eps= 50.0 -> 군집 2개, 잡음 0개
eps= 100.0 -> 군집 2개, 잡음 0개
eps= 200.0 -> 군집 2개, 잡음 0개[A]의 결과는 세 신호 성분과 정확히 일치합니다. 군집 0은 0.00초부터 2.00초까지 500 Hz에서 2500 Hz로 이어지는 처프이고, 군집 1은 1.20초부터 1.40초까지 688 Hz에 머무는 버스트이며 (실제 700 Hz, 주파수 분해능 31.25 Hz 기준으로 22번 빈이 687.5 Hz입니다), 군집 2는 0.30초부터 1.70초까지의 3200 Hz 정현파입니다. 지속 시간과 주파수 범위가 모두 설계값과 맞아떨어집니다.
주목할 부분은 $\varepsilon$을 2.5에서 8.0까지 세 배 이상 바꾸어도 결과가 흔들리지 않았다는 점입니다. 성분들이 시간-주파수 평면에서 충분히 떨어져 있으면 파라미터에 대한 민감도가 크게 낮아집니다. 4절에서 본 초승달 데이터의 아슬아슬한 동작과 대비되는 지점입니다.
[B]는 4절 마지막에 언급한 스케일 문제를 수치로 보여 줍니다. 초와 Hz를 그대로 좌표로 쓰면 주파수 축의 값이 시간 축보다 수천 배 크므로, 유클리드 거리는 사실상 주파수 차이만 반영합니다. 시간 방향의 연결 관계가 통째로 사라지기 때문에 $\varepsilon$을 어떻게 잡아도 올바른 3개 군집이 나오지 않습니다. 작으면 58개로 흩어지고, 키우면 2개로 뭉개질 뿐입니다.
여기서 빈 인덱스 좌표를 쓴 것은 단순한 표준화보다 나은 선택이었습니다. STFT의 시간 축 격자 간격은 8 ms, 주파수 축 격자 간격은 31.25 Hz인데, 빈 인덱스로 바꾸면 두 축 모두 눈금 간격이 1이 됩니다. 그러면 $\varepsilon = 3.0$은 "격자 세 칸 반경 이내"라는 뜻이 됩니다. 시간 축으로만 재면 24 ms, 주파수 축으로만 재면 93.75 Hz까지 이어 주며, 대각선 방향은 두 축이 예산을 나눠 쓰므로 그보다 짧습니다. $\varepsilon$에 도메인 의미를 부여할 수 있는 좌표계를 고르는 것이 DBSCAN을 실무에 적용할 때 가장 중요한 설계 결정입니다.
같은 틀은 여러 곳에 그대로 옮겨 갑니다. 라이다 점군에서 지면을 제거한 뒤 물체 단위로 분할할 때, CFAR 검출기 출력에서 하나의 표적이 만든 여러 셀을 하나로 묶을 때, 진동 센서의 특징 공간에서 정상 운전 영역을 벗어난 이상 구간을 찾을 때가 모두 그렇습니다. 공통점은 군집의 개수를 모르고, 모양이 볼록하지 않으며, 어디에도 속하지 않는 점을 그대로 남겨 두어야 한다는 것입니다.
이 가운데 라이다 점군은 이 글에서 다룬 논점들이 한꺼번에 모이는 사례이므로 조금 더 들여다볼 만합니다. 도입부에서 언급한 대로 라이다는 물체의 표면만 샘플링하므로 벽면은 판, 기둥은 반쪽 원통 껍질로 나타납니다. 반지름 $R$인 원통 껍질에서 가시 호가 180°이면 무게중심은 축으로부터 $0.637R$, 120°이면 $0.827R$ 지점에 놓이는데, 어느 쪽이든 $R$보다 작으므로 무게중심은 언제나 기둥 안쪽, 즉 측정점이 원리적으로 존재할 수 없는 공간에 떨어집니다. 5.3절에서 초승달 군집을 예로 들어 설명한 문제의 3차원 실물판입니다. 반면 점군에서 하나의 물체를 정의하는 것은 표면의 연결성입니다. 같은 물체 위의 점들은 센서의 각분해능 간격으로 끊김 없이 이어지고 서로 다른 물체 사이에는 빈 공간이 놓이므로, 이는 밀도 연결성의 정의와 정확히 일치합니다.
그런데 라이다는 동시에 5.1절에서 본 밀도 편차 문제의 교과서적 사례이기도 합니다. 회전형 라이다의 점 간격은 거리에 비례해 벌어지기 때문입니다. 각분해능이 수평 0.1°, 수직 0.4° 급이라고 두면 수평 간격은 5 m에서 0.87 cm, 50 m에서 8.73 cm가 되고, 수직 간격은 같은 구간에서 3.49 cm가 34.91 cm까지 벌어집니다. 표면 점밀도는 $1/r^2$로 감소하므로 한 번의 스캔 안에 100배의 밀도 격차가 존재합니다. 5.1절에서 제가 인위적으로 만든 격차가 8배 남짓이었고 그것만으로도 단일 $\varepsilon$이 무너졌다는 점을 떠올려 보시면, 원형 그대로의 DBSCAN이 왜 잘 듣지 않는지 짐작하실 수 있습니다. 실무에서 거리에 따라 $\varepsilon$을 키우거나, 복셀 격자로 점밀도를 균질화하거나, 구면 좌표계로 옮겨 각도 단위로 군집화하는 이유가 여기에 있습니다. 마지막 방법은 앞서 스펙트로그램에서 빈 인덱스 좌표를 택한 것과 정확히 같은 발상입니다. $\varepsilon$이 "센서 기준 몇 도 이내"라는 물리적 의미를 되찾기 때문입니다. 아울러 지면 제거가 반드시 선행되어야 합니다. 바닥은 장면의 모든 물체에 닿아 있는 거대한 연속면이라, 그대로 두면 밀도 연결성을 타고 장면 전체가 하나의 군집으로 이어져 버립니다.
마치며
데이터를 분석하는 과정에서 거리(Distance)라는 척도 하나만으로 모든 관계를 규명하려 할 때 우리는 종종 벽에 부딪힙니다. k-means가 보여 준 평면적인 분할과 계층적 군집화가 그려 낸 계통수 모델은 훌륭한 통찰을 제공하지만, 그 공간에 섞여 있는 무의미한 잡음과 불규칙한 모양을 처리하기에는 부족함이 있었습니다.
DBSCAN은 점과 점 사이의 거리를 넘어, 그 거리 안에 점들이 얼마나 빽빽하게 모여 있는가라는 밀도의 개념을 도입함으로써 비지도 학습의 패러다임을 한 단계 확장시켰습니다. $\varepsilon$은 여전히 거리이지만 판정의 기준은 그 반경 안에 들어온 점의 개수이며, 척도가 거리에서 개수로 한 칸 옮겨 간 것만으로 "군집이란 밀도가 끊기지 않고 이어진 영역"이라는 새로운 정의가 성립합니다.
그리고 이 정의 하나에서 장점과 한계가 모두 따라 나옵니다. 형태에 대한 가정이 없으므로 초승달과 동심원을 잡아내고, 군집의 개수를 정의에 포함하지 않으므로 그것을 인간이 찍어 맞추지 않아도 되며, 밀도 임계가 있으므로 잡음을 데이터의 자연스러운 일부로 인정하면서 분리해 냅니다. 실제 엔지니어링 문제에서 이 알고리즘이 대체 불가능한 영역을 구축하고 있는 이유입니다. 동시에 밀도 기준이 전역 상수이므로 밀도가 크게 다른 군집들을 함께 다루지 못하고, 거리 개념에 의존하므로 고차원에서 무력해지며, 중심이라는 개념이 없으므로 대표 벡터를 내놓지 못합니다.
지금까지 다룬 세 알고리즘을 정리하면 다음과 같습니다.
| 항목 | k-means | 계층적 군집화 | DBSCAN |
|---|---|---|---|
| 군집 개수 | 사전 지정 | 절단 높이로 사후 결정 | 자동 결정 |
| 군집 형태 | 볼록(보로노이 영역) | 연결 기준에 따라 다름 | 임의 |
| 잡음 처리 | 없음(모두 배정) | 없음(모두 배정) | 명시적 잡음 레이블 |
| 주요 파라미터 | $k$ | 연결 기준, 절단 높이 | $\varepsilon$, MinPts |
| 시간 복잡도 | $O(nkdt)$ | $O(n^2 \log n)$ | $O(n \log n) \sim O(n^2)$ |
| 공간 복잡도 | $O(nd)$ | $O(n^2)$ | $O(n)$ |
| 대표 벡터 | 제공(코드북) | 없음 | 없음 |
| 결과의 결정성 | 초기값 의존 | 결정적 | 경계점만 순서 의존 |
※ $n$: 점 개수, $k$: 군집 개수, $d$: 특징 차원, $t$: 반복 횟수
선택의 기준도 비교적 명확합니다. 압축이나 양자화를 위해 대표 벡터가 필요하면 k-means입니다. 군집 개수를 정하기 전에 데이터의 계층 구조를 눈으로 살펴보고 싶고 데이터 규모가 크지 않다면 계층적 군집화입니다. 형태를 모르는 군집을 찾아야 하고 이상치를 걸러 내야 하며 데이터가 크다면 DBSCAN입니다. 그리고 군집마다 밀도가 크게 다르다면, 이 글에서 확인한 대로 DBSCAN 대신 HDBSCAN으로 시작하시는 편이 시간을 아끼는 길입니다.
실무 점검 순서도 정리해 두겠습니다. 특징 스케일을 먼저 정리하고(가능하면 $\varepsilon$에 물리적 의미가 생기는 좌표계를 고르십시오), $\text{MinPts}$를 $2d$ 부근에서 정한 뒤, k-거리 그래프로 $\varepsilon$의 출발점을 잡고, 그 주변을 훑으며 군집 개수와 잡음 비율을 함께 관찰하십시오. 잡음 비율만으로 판단하면 파편화를 개선으로 오인하게 됩니다. 그리고 잡음으로 분류된 점들을 반드시 한 번은 들여다 보십시오. 계측 데이터에서는 그 점들이 버려야 할 오차가 아니라, 실은 우리가 찾고 있던 이상 징후인 경우가 적지 않습니다.
거리에 의존한 분할에서 밀도 기반의 확장까지, 군집화 알고리즘의 발전 과정을 따라오면서 우리는 데이터가 가진 숨은 규칙을 끄집어내는 수학적 도구들의 진화를 목격했습니다. 오늘 살펴본 DBSCAN의 한계를 다시 한번 극복하는 HDBSCAN 같은 현대적인 확장 모델을 공부하기 위해서라도, 밀도와 핵심점이라는 오늘 다룬 기초 개념들을 단단하게 다져 두시기 바랍니다.
📖 참고문헌
- Ester, M., Kriegel, H.-P., Sander, J., & Xu, X. (1996).
A Density-Based Algorithm for Discovering Clusters in Large Spatial Databases with Noise.
KDD-96, 226–231. https://cdn.aaai.org/KDD/1996/KDD96-037.pdf - Sander, J., Ester, M., Kriegel, H.-P., & Xu, X. (1998).
Density-Based Clustering in Spatial Databases: The Algorithm GDBSCAN and Its Applications.
Data Mining and Knowledge Discovery, 2(2), 169–194. https://doi.org/10.1023/A:1009745219419 - Schubert, E., Sander, J., Ester, M., Kriegel, H.-P., & Xu, X. (2017).
DBSCAN Revisited, Revisited: Why and How You Should (Still) Use DBSCAN.
ACM Transactions on Database Systems, 42(3), Article 19, 1–21. https://doi.org/10.1145/3068335 - Ankerst, M., Breunig, M. M., Kriegel, H.-P., & Sander, J. (1999).
OPTICS: Ordering Points To Identify the Clustering Structure.
SIGMOD 1999, 49–60. https://doi.org/10.1145/304182.304187 - Campello, R. J. G. B., Moulavi, D., & Sander, J. (2013).
Density-Based Clustering Based on Hierarchical Density Estimates.
PAKDD 2013, LNCS 7819, 160–172. https://doi.org/10.1007/978-3-642-37456-2_14 - Campello, R. J. G. B., Moulavi, D., Zimek, A., & Sander, J. (2015).
Hierarchical Density Estimates for Data Clustering, Visualization, and Outlier Detection.
ACM Transactions on Knowledge Discovery from Data, 10(1), Article 5. https://doi.org/10.1145/2733381 - Ward, J. H. (1963).
Hierarchical Grouping to Optimize an Objective Function.
Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845 - Linde, Y., Buzo, A., & Gray, R. M. (1980).
An Algorithm for Vector Quantizer Design.
IEEE Transactions on Communications, 28(1), 84–95. https://doi.org/10.1109/TCOM.1980.1094577 - Hubert, L., & Arabie, P. (1985).
Comparing Partitions.
Journal of Classification, 2(1), 193–218. https://doi.org/10.1007/BF01908075 - Beyer, K., Goldstein, J., Ramakrishnan, R., & Shaft, U. (1999).
When Is "Nearest Neighbor" Meaningful?
ICDT 1999, LNCS 1540, 217–235. - Pedregosa, F., et al. (2011).
Scikit-learn: Machine Learning in Python.
Journal of Machine Learning Research, 12, 2825–2830. https://www.jmlr.org/papers/v12/pedregosa11a.html
🏷️ 코드 및 그림 출처
본문 실습은 scikit-learn(Pedregosa et al., 2011)과 NumPy·SciPy로 생성한 합성 데이터를 사용하였습니다. 본문의 코드는 생성형 AI의 도움을 받아 초안을 작성한 뒤 필자가 검토·수정하고 직접 실행하여 결과를 검증한 것이며, 위젯은 필자가 직접 제작하였습니다. 그림은 모두 위 코드의 실행 결과이며, 참고문헌에 수록된 논문의 도표를 전재한 것은 없습니다.